Considerando Uma Aplicação Java Que Gerencia Informações
Configurando persistência em aplicações Java de gestão de dados
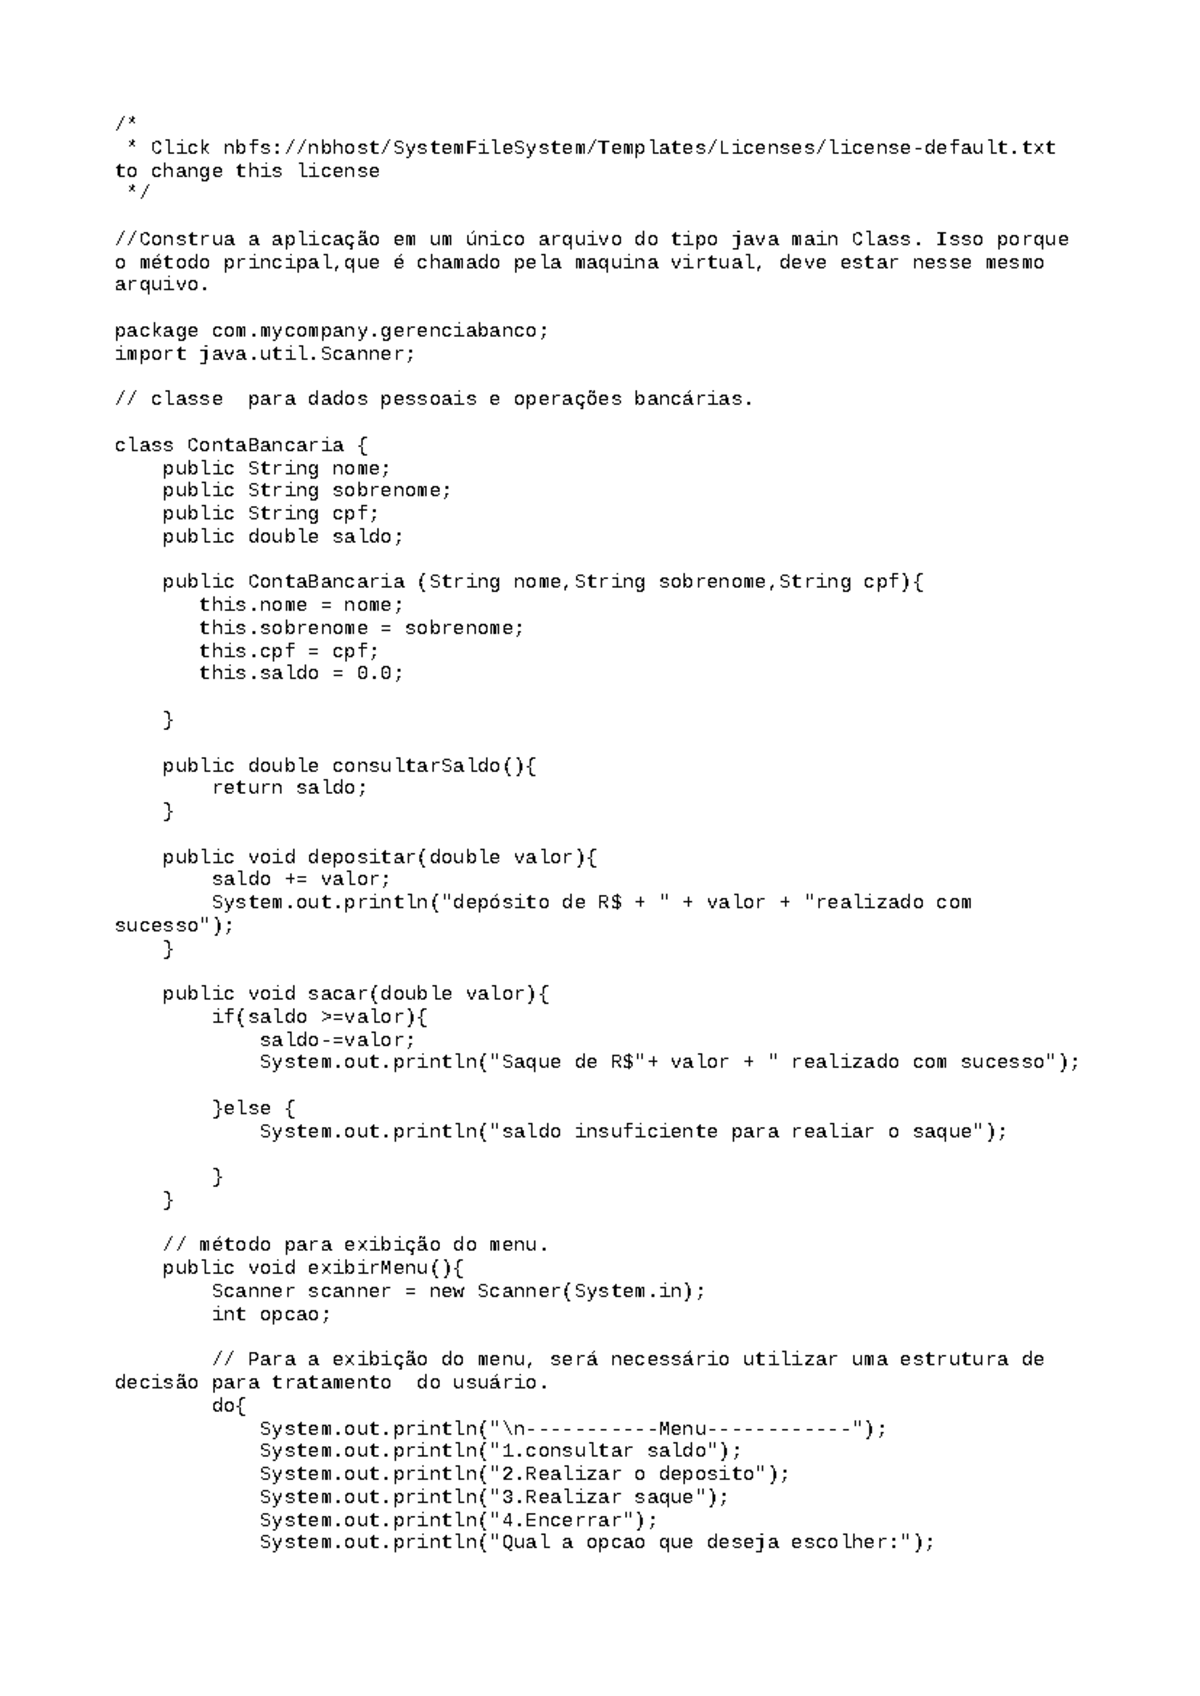
Quando considerando uma aplicação java que gerencia informações, a primeira decisão técnica que define a arquitetura inteira é como você vai persistir e acessar esses dados. A maioria dos projetos começa com SQL puro e JDBC, porque é o caminho mais direto. Mas depois de dois ou três meses de uso intensivo, você percebe que cada consulta manual está gerando N+1 queries no banco, e o application server já está com o pool de conexões saturado. Esse é o ponto onde Spring Data JPA ou EclipseLink deixam de ser luxo e viram necessidade prática. O primeiro passo concreto é definir se você usa JPA com Hibernate, Spring Data JPA, ou vai por MyBatis. A diferença não é só sintaxe, muda completamente como as transações se comportam e como você lida com caches. Eu configurei um sistema de inventário para uma distribuidora de peças automotivas com mais de 40 mil SKUs. No início, usamos Spring Data JPA com findByQuery customizado. Em produção, uma simples busca por faixa de preço e categoria disparava 87 queries em vez de uma. A solução foi adicionar @EntityGraph com atributos definidos no repository, o que reduziu o tempo de resposta de 1,2 segundos para 140 milissegundos sem tocar no SQL manualmente. Mapeamento de entidades exige atenção a ciclos de referência. Se você mapear Categoria com Set
O segundo passo é configurar o pool de conexões. HikariCP é o padrão atual, mas a configuração default muitas vezes é insuficiente. Para uma aplicação que processa cerca de 300 transações por minuto, você precisa ajustar maximum-pool-size para o dobro do número de cores da CPU, não o dobro que a documentação sugere. Coloque connection-timeout em 30 segundos, idle-timeout em 10 minutos, e max-lifetime em 30 minutos para evitar connections mortas causadas por firewalls que matam conexões inativas após 5 minutos.
Transações e integridade referencial na prática
Transações com @Transactional têm regras que muitos ignoram. Se você chamar um método transacional de dentro do mesmo bean, o proxy do Spring não intercepta a chamada. A transação não inicia. A solução mais simples é injetar o próprio bean via @Autowired ou quebrar o método em um bean separado. Encontrei esse problema em um sistema de controle financeiro onde conciliações bancárias falhavam intermitentemente porque a validação e a gravação estavam no mesmo serviço. Após separar para dois beans, os failsafe começaram a funcionar consistentemente. A integridade referencial no banco deve ser tratada com cuidado. Constraints FOREIGN KEY com ON DELETE CASCADE são úteis, mas podem apagar lotes inteiros de registros históricos se alguém deletar um registro mestre por engano. Em sistemas de gestão de informações críticas, prefira soft delete com colunas deleted_at boolean e indexes compostos que incluam essa coluna. Isso adiciona complexidade nas queries, mas evita perda irreversível de dados que já vi acontecer em pelo menos dois projetos por decisões de arquitetura mal avaliadas. Queries nativas vs JPQL precisam de uma escolha consciente. JPQL funciona bem para relacionamentos mapeados e é portável entre bancos. Queries nativas com @Query(nativeQuery = true) são necessárias quando você precisa de funcionalidades específicas do banco, como window functions ou JSON operators no PostgreSQL. O problema é que a Native Query quebra a portabilidade e exige que cada ambiente de banco tenha seu dialect configurado corretamente no spring.jpa.properties.hibernate.dialect. Errar isso gera erros silenciosos de tipagem que aparecem só em homologação.
Performance e monitoramento em produção
O terceiro passo é habilitar métricas de persistência. Micrometer com Spring Boot Actuator expõe dados de connection pool, query counts, e slow queries. Configure slow-query-log no banco e use o Hibernate Statistics ou P6Spy para capturar queries que levam mais de 500ms. Sem esses dados, você está operando no escuro. Instalei P6Spy em um sistema de relatórios mensais que demorava 14 segundos para gerar um CSV. Identifiquei que uma subconsulta repetida era executada uma vez por linha do resultado principal. Substituí por um join com grouped aggregation e o tempo caiu para 1,8 segundos. Caching em segunda nível com Hibernate requer configuração específica por provedor. Se usar Ehcache ou Redis, defina time-to-live e time-to-idle apropriados. Cache com TTL infinito pode servir dados antigos por dias se a camada de invalidação não estiver implementada. Para dados financeiros ou de estoque, TTL máximo de 30 segundos costuma ser o equilíbrio certo entre performance e consistência eventual. A principal limitação dessa abordagem é que JPA introduz overhead de abstração que não existe em ORM tradicionais ou acesso direto. Para relatórios analíticos com milhões de linhas, Spring Data JPA pode não ser a ferramenta certa. Nesse caso, MyBatis com queries SQL otimizadas ou até acesso JDBC direto com-rowmapper personalizado entrega performance 3 a 5 vezes maior. A escolha depende do volume e da criticidade de latência do seu sistema.
O deploy final deve incluir flyway ou liquibase para versionamento de schema. Migrar tabelas manualmente em produção é uma fonte conhecida de incidentes. Scripts de migração devem ser idempotentes, testados em ambiente espelhado, e aplicados com rollback strategy definida antes do go-live. Projetos que pularam essa etapa já vi perder horas de operação porque uma coluna adicionada quebrou uma integração com sistema legado que não esperava o novo campo. Documentação do stack inclui Spring Framework Reference, Hibernate User Guide, e HikariCP README. Para casos específicos de performance, o book High Performance Java Persistence de Vlad Mihalcea oferece benchmarks reais que extrapolam a teoria oficial. A curva de aprendizado inicial é íngreme, mas a redução de bugs de integridade e a estabilidade em carga justificam o esforço a médio prazo.
Galeria
-

Fases de uma aplicação Java -

Fases de uma aplicação Java -

Tutorial aplicação Java desktop parte 3 - Docsity -

GitHub - Artur-Neves/Gerenciamento-escolar_java: Aplicação desktop em ...
