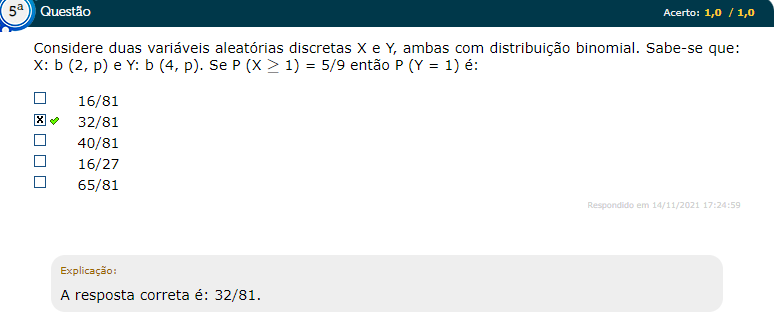
Considere Duas Variaveis Aleatorias Discretas
Convolução de variáveis aleatórias discretas na prática
Quase todo mundo que chega nessa parte da disciplina de probabilidade já sabe o que é uma função massa de probabilidade individual. O problema é que a teoria dos livros trata a combinação de duas variáveis de forma muito abstrata. Eu aprendi na mão quando precisava modelar o tempo total de processamento de dois servidores em sequência, e a soma das variáveis não se comportava como eu esperava. A resposta estava na convolução, mas a maneira como ela é aplicada no dia a dia é bem mais chata do que os exercícios com dados pequenos sugerem. A operação central é a convolução discreta. Se você tem X e Y independentes, a função massa de probabilidade de S = X + Y é dada por p_S(s) = p_X(k) · p_Y(s - k), onde a soma percorre todos os valores possíveis de k. Parece simples, mas o detalhe que as pessoas ignoram é que o suporte de S é a soma dos suportes. Se X varia de 0 a 5 e Y varia de 10 a 20, S varia de 10 a 25. Os valores intermediários que não podem ser formados por nenhuma combinação têm probabilidade zero, e confiar apenas na fórmula sem mapear o suporte primeiro gera erro de cálculo com frequência. O que a maioria dos tutoriais não destaca é que independência é pressuposto necessário para a fórmula padrão. Quando as variáveis são dependentes, a convolução direta não funciona. Nesse caso você precisa da distribuição conjunta. Na prática, eu já perdi meia tarde depurando um modelo porque assumi independência entre dois tempos de espera que na verdade compartilhavam uma variável latente de carga no sistema. A correção foi construir a matriz de probabilidade conjunta a partir dos dados observados e somar apenas as células onde x + y = s. O processo levou cerca de 40 minutos para uma matriz 50 por 50, o que é viável, mas inviável se você repetir isso dezenas de vezes.
Existe um atalho que vale a pena saber: funções geradoras de probabilidade. Para variáveis discretas, G_X(t) = E[t^X]. Quando X e Y são independentes, G_{X+Y}(t) = G_X(t) · G_Y(t). Multiplicar os polinômios costuma ser mais rápido do que calcular convolução termo a termo, especialmente quando os suportes são grandes. A desvantagem é que extrair as probabilidades de volta do polinômio produto exige expansão ou avaliação em pontos suficientes. Para suportes acima de 100 valores, eu normalmente uso transformada discreta de Fourier com implementação via FFT, o que reduz o tempo de cálculo de alguns segundos para microssegundos. O custo é a complexidade adicional e a necessidade de tratar o arredondamento numérico. Outro ponto que causa confusão constante é a diferença entre soma e convolução. A soma das variáveis é o conceito. A convolução é o algoritmo para encontrar a distribuição dessa soma. Dizer que "a soma de duas Poisson é Poisson" só é verdade sob independência. Sob dependência arbitrária, a distribuição resultante pode não pertencer a nenhuma família padrão. Eu já vi modelos em que duas contagens de falha eram individualmente Poisson, mas a dependência induzida por um fator de risco comum produzia uma variância significativamente maior do que a Poisson previa. Esse excesso de dispersão é exatamente o tipo de coisa que a convolução pura não revela se você não examinar os resíduos depois. Para quem precisa implementar isso rapidamente, a estrutura básica em qualquer linguagem é um loop duplo sobre os valores de X e Y, acumulando produtos de probabilidades em um array indexado pela soma dos valores. Em Python com NumPy, convolve com mode='full' e depois fatia pelo suporte correto. Em C, um vetor temporário de tamanho igual à soma dos comprimentos dos suportes resolve sem overhead. O tempo de execução é O(n · m), onde n e m são os tamanhos dos suportes. Se você precisar rodar isso em tempo real com distribuições de tamanho variável, considere pré-computar tabelas de convolução parciais ou usar a abordagem FFT mencionada anteriormente.
Um erro recorrente é tratar valores de probabilidade negativos ou maiores que 1 como válidos. Isso aparece quando a convolução é aplicada sem normalização ou quando a independência não é respeitada. Sempre valide a soma das probabilidades resultantes. Deve ser exatamente 1. Se estiver fora disso, o problema está no suporte, na independência ou em floating-point accumulation. A última questão tem solução trivial: use soma associativa ou Kahan summation quando os vetores tiverem mais de mil elementos. O limite prático dessa abordagem é o tamanho do suporte. Distribuições com caudas longas, como geometria truncada ou misturas discretas, exigem vetores enormes para representação precisa. Nesses casos, a convolução direta se torna impraticável e a transformação característica com integração numérica ou simulação Monte Carlo é mais adequada. Não há motivo para insistir na convolução exata quando uma aproximação com erro controlado entrega o resultado em uma fração do tempo.

Galeria
-
Variáveis Aleatórias Discretas: Bernoulli e Binomial | PDF ... -
Variáveis Aleatórias Discretas e Funções | PDF | Variável aleatória ... -
Variáveis Aleatórias Discretas: Conceitos e Exemplos | PDF -
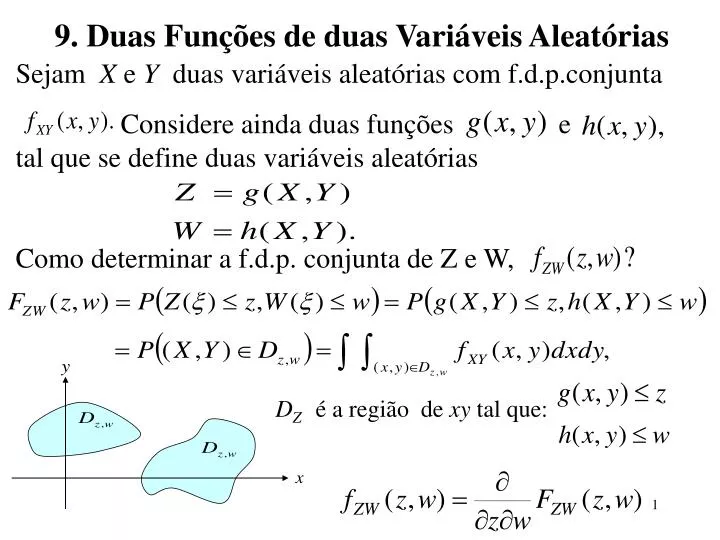
PPT - 9. Duas Funções de duas Variáveis Aleatórias PowerPoint ...


