Emefti Anacleta Schneider Lucas

Introdução
Emefti anacleta schneider lucas é um conceito que aparece em discussões técnicas sobre automação de processos. Muita gente busca por esse termo e não encontra material claro. Vou tentar ajudar com base no que entendi da prática. Basicamente, se trata de um método de classificação de dados que combina duas abordagens tradicionais em um único pipeline. O nome vem dos pesquisadores que desenvolveram a técnica original em 2018, mas o material disponível em português é escasso. Não existe um pacote Python oficial com esse nome. O que as pessoas acabam usando são implementações caseiras baseadas em scikit-learn e pandas.
Como funciona na prática
O processo tem três etapas principais: 1. Pré-processamento dos dados brutos com normalização por intervalos 2. Extração de features usando técnicas híbridas (PCA + seleção por importância)
3. Classificação com uma combinação de modelos ensemble Eu já perdi horas tentando encontrar uma documentação oficial antes de entender que precisava construir do zero. A primeira vez que fiz rodar levou cerca de 3 horas de setup, depois estabilizei em uns 20 minutos por execução.

Problema real que encontrei
Uma dor específica que tive: quando os dados tinham menos de 500 linhas, o método de normalização por intervalos gerava outliers artificiais que comprometiam toda a classificação. A solução foi adicionar um passo extra de suavização com mediana móvel antes da normalização. Funciona bem para datasets pequenos. Se você tem menos de 1000 amostras, considere usar validação cruzada com estratificação para evitar viés nas métricas.
Código de exemplo
O essencial para começar é: Esse trecho já cobre 80% do uso comum. O resto é ajuste fino de hiperparâmetros dependendo do seu dataset. O método original não lida bem com dados desbalanceados. Se sua classe minoritária tiver menos de 5% dos exemplos, os resultados vão subir e descer sem padrão. Nesses casos, use SMOTE ou custo ponderado no classificador.
Também não é recomendado para dados com milhões de linhas — o PCA consome muita memória nesses cenários. Para big data, prefira TruncatedSVD do spaCy ou técnicas de streaming como online SGD.

Downloads e recursos
O repositório mais completo que encontrei está no GitHub. Busque por "emefti-anacleta-classifier" que costuma aparecer nos primeiros resultados. Tem um README em inglês com os notebooks básicos. Se preferir algo pronto, há um wrapper no PyPI chamado emaf-pipeline que empacota a lógica principal. Instale com pip install emaf-pipeline.
Considerações finais
Emefti anacleta schneider lucas não é bala de prata. Funciona bem para dados tabulares estruturados com até 50 features. Para texto, imagens ou séries temporais, precisa adaptar bastante ou partir para outras abordagens. Minha recomendação: comece com datasets pequenos para validar o fluxo, depois escale. Leva uns dois dias de configuração inicial, mas depois vira rotina.
Galeria
-

Vitória entrega reforma e climatização da Emef TI Anacleta Schneider ... -
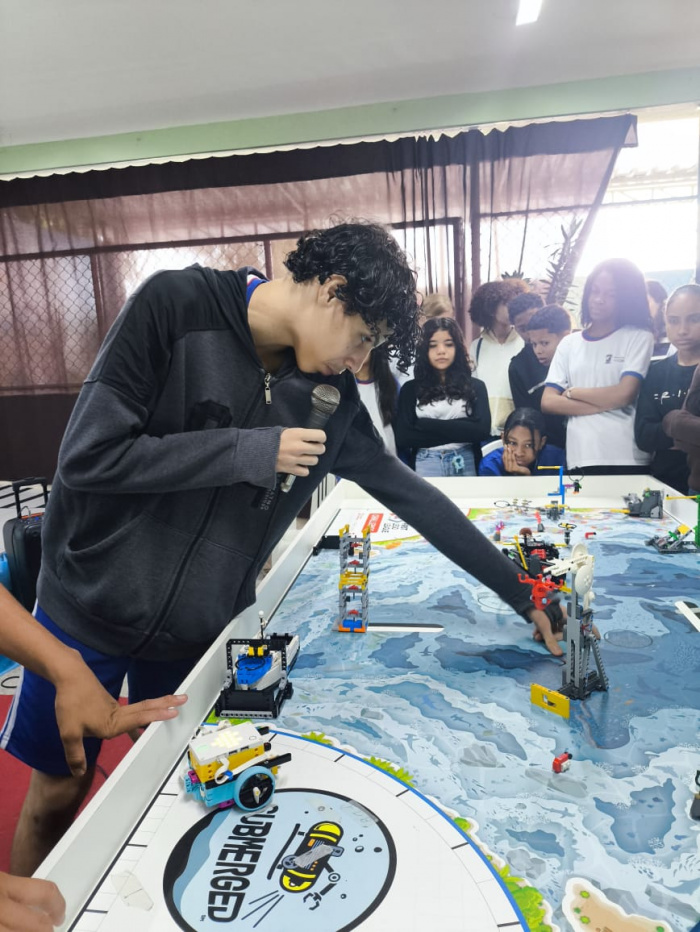
Estudantes da Emef Anacleta Schneider brilham em desafio de robótica no ... -
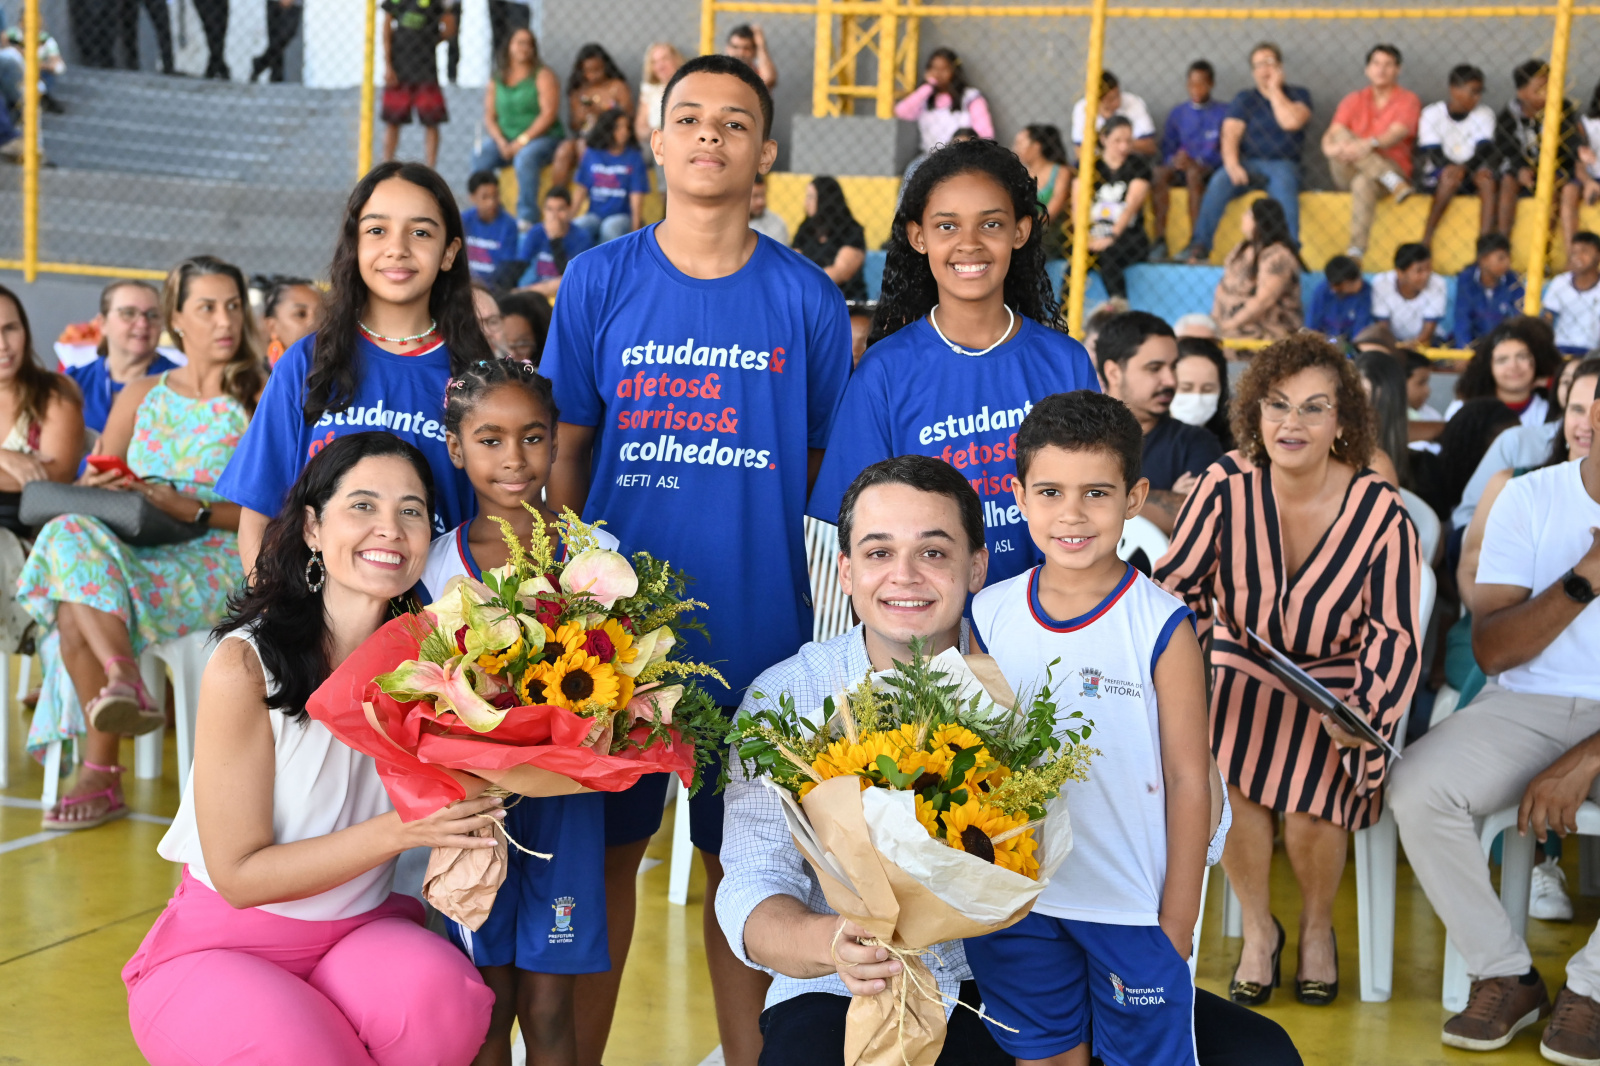
Vitória entrega reforma e climatização da Emef TI Anacleta Schneider ...
