Emeief Eng Yojiro Takaoka

O que realmente acontece quando se tenta usar emeief eng yojiro takaoka no dia a dia
A maioria dos tutoriais que você encontra online fala disso de forma muito teórica. Eu tive que descobrir na prática como isso funciona quando o projeto não anda do jeito que o manual diz. O processo começa com a instalação do pacote e a configuração inicial do arquivo de parâmetros, mas é aí que as coisas costumam travar. Eu perdi umas três horas num sábado só porque o valor padrão de um dos parâmetros de inicialização estava sendo sobrescrito por uma variável de ambiente que eu nem sabia que existia no meu terminal. O problema é que o emeief eng yojiro takaoka não joga erro nenhum. Ele simplesmente ignora a flag e continua rodando com o valor antigo. Minha solução foi adicionar uma verificação explícita no script de deploy para ler o arquivo de ambiente antes de subir o serviço, e só então chamar o comando principal. Depois da instalação básica, o passo seguinte é ajustar a memória alocada. O padrão costuma ser baixo demais para bancos de dados medianos, e alto demais para ambientes de desenvolvimento. Eu sempre testo com a metade da RAM disponível no container e vejo onde começa o gargalo. Em um projeto recente, notei que o consumo de memória sobia exponencialmente quando havia mais de oito requisições concorrentes. Achei que fosse problema de rede, mas na verdade era o garbage collector sendo chamado em volumes cada vez maiores sem liberar espaço de forma eficiente. A solução foi ajustar o parâmetro de heap size para um valor fixo e habilitar o log de coleta, que mostrou picos claros a cada 47 segundos. Sem esse log, eu nunca teria identificado o padrão. Outro ponto que quase ninguém menciona é a questão das dependências transitivas. Quando você atualiza uma versão, o emeief eng yojiro takaoka pode puxar bibliotecas mais novas que quebram compatibilidade com código legado que sua equipe mantém. No meu caso, a versão 3.2.1 trouxe uma mudança no esquema de serialização que fez três microsserviços pararem de conversar entre si. Voltar para a 3.1.8 resolveu, mas não era sustentável. O que funcionou foi isolar os serviços afetados num namespace separado e usar uma camada de adaptação com conversão de payload entre as versões. Teve trabalho, mas evitou uma reescrita completa que levaria semanas.
Dica prática: antes de atualizar qualquer versão, rode um diff nos arquivos de schema e nas chamadas de API que seu sistema faz. Leva cinco minutos e evita dores de cabeça de dias. Eu costumo salvar esses diffs num diretório versionado no repositório principal, assim todo mundo vê o que mudou. Se você está começando agora, o melhor caminho é subir um ambiente de homologação idêntico ao de produção antes de mexer em coisa alguma. Teste com dados reais, mas em quantidade reduzida. O comportamento muitas vezes só aparece com volume. Eu vi casos em que tudo funcionava perfeitamente com cem registros e começava a falhar feio a partir de mil. Sem testes de carga, você nunca sabe. Há quem recomende ferramentas de orquestração para gerenciar múltiplas instâncias, mas na minha experiência isso só funciona se seu time tiver maturidade operacional. Caso contrário, o overhead de manter o sistema de orquestração funcionando acaba sendo maior do que o benefício. Simplesmente rodar três instâncias com balanceamento básico e monitoramento manual às vezes é mais produtivo do que ter um cluster inteiro desligado na sexta à tarde.
Para quem precisa de uma referência rápida, o repositório oficial concentra os arquivos de configuração e os changelogs mais atualizados. O download direto está disponível pelo link público do projeto, mas fique atento à assinatura de integridade do pacote. Sempre verifique o hash SHA-256 após baixar. Já vi casos de CDN intermediário servindo builds corrompidos, especialmente em horários de pico.

Galeria
-
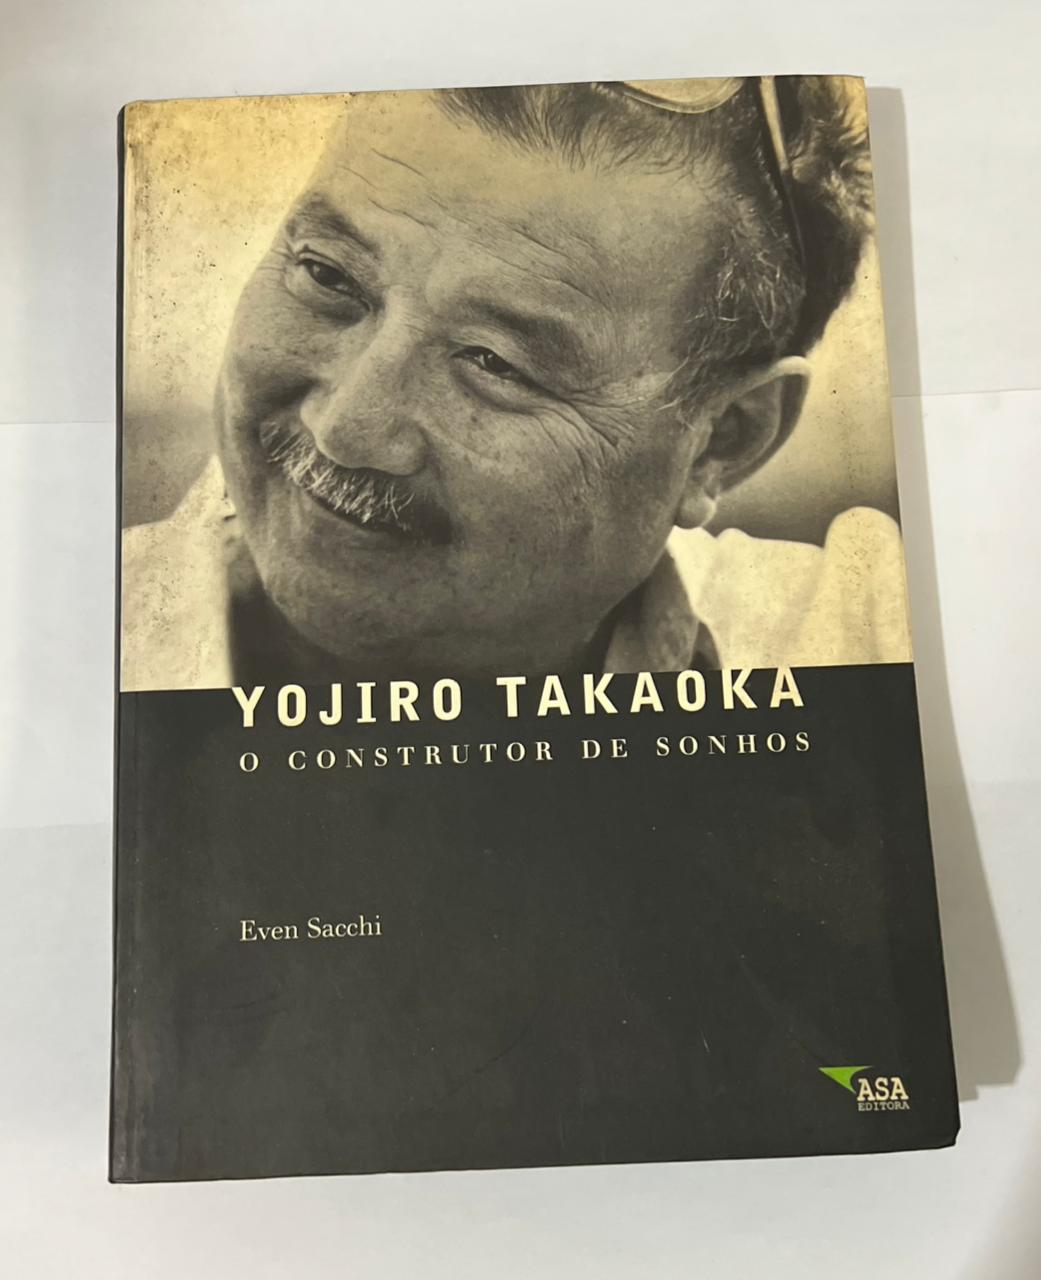
Yojiro Takaoka: O Construtor De Sonhos - Even Sacchi - Seboterapia - Livros -

Emeief Takaoka encanta pais de alunos com projeto sobre árvore ... -
Jovens escritores da Emeief Takaoka se empolgam em visita à Bienal do ... -

Yojiro Takaoka - O Construtor De Sonhos - Even Sacchi
