Especialista Em Big Data
O que faz na prática um especialista em big data
A maior parte do trabalho não tem a ver com ferramentas bonitas de dashboards ou gráficos coloridos que aparecem em lives do YouTube. Tem a ver com dados que são enormes demais para caberem na memória, pipelines que quebram às 3h da manhã e decisões ruins que aconteceram há dois anos e agora estão custando milhões. Eu não tenho título nenhum. A trajetória foi mais ou menos assim: fui estagiário numa startup de e-commerce e o banco de dados PostgreSQL simples já ia pro saco com 50GB de inserts por minuto. Um colega que entendia um pouco mais me disse para testar com partições, eu testei, funcionou e não funcionou. Aí comecei a brincar com Spark pra validar. Foi assim mesmo. O caminho real passa por três pilares que todo mundo fala mas ninguém explica direito. Primeiro, saber programar de verdade. Não só escrever queries mas entender o que acontece quando o código vai pra produção. Segundo, dominar ao menos um framework distribuído. Terceiro, entender o problema de negócio por trás dos dados. Isso é o que separa quem apenas manipula coisas de quem resolve problemas reais.
As ferramentas que importam hoje são relativamente poucas. Apache Spark continua sendo o padrão da indústria, Hadoop HDFS é o sistema de arquivos que ainda segura muitas bases, Kafka para streaming em tempo real, e uma variedade enorme de tecnologias cloud como Databricks, EMR, BigQuery e Snowflake. O importante é escolher uma e aprender até o osso antes de pular pra outra.
Problemas reais que ninguém conta
Um dos problemas mais chatos que eu encontrei foi com dados duplicados vindos de múltiplas fontes. O cliente tinha três sistemas ERP diferentes e cada um gerava números distintos. A solução não foi mágica. Criei uma lógica de reconciliação com fuzzy matching e weighting por fonte de confiança. Achei isso muito chato mas funcionou. Outro problema clássico é o que chamamos de data skew em jobs Spark. Você tem uma chave de partição que recebe 80% dos dados e o resto fica esperando. A workaround que eu uso é salting: adiciono um prefixo randomizado na chave antes do shuffle. Isso distribui melhor mas aumenta o tempo de processamento em cerca de 15 a 20 por cento. Vale a pena em quase todos os casos. O custo escondido de big data é sempre o armazenamento. Dados brutos ocupam espaço. Dados processados ocupam mais espaço ainda porque ninguém limpa nada. Meu conselho é: defina uma política de retenção desde o início. Dados que não são usados há 90 dias devem ir pro cold storage automaticamente. Isso corta custos em até 60 por cento em projetos que já existem.

Mitos que precisam parar
Big data não é sinônimo de machine learning. Muita gente acredita nisso e acaba gastando fortunas em infraestrutura pra nada. Machine learning é apenas uma aplicação possível. A maioria dos projetos de big data que eu vi nunca chegaram a treinar um único modelo. Outro mito é que big data resolve tudo. Dados ruins não viram dados bons só por serem muitos. Se a qualidade da entrada é ruim, o resultado será ruim, não importa quanta potência de processamento você jogue no problema. Limpeza de dados representa cerca de 70 por cento do trabalho em qualquer projeto séria. A última ideia equivocada é que precisa de hardware poderoso. Hoje em dia quase tudo roda em cloud. Contratar um cluster on-premise só faz sentido quando o volume ultrapassa 10TB diários de dados processados. Para a maioria das empresas, soluções como Databricks Community Edition ou Google Colab são suficientes pra começar.
Um passo a passo prático
Se você quer entrar nessa área, comece com Python e SQL. São as únicas habilidades que realmente importam nos primeiros meses. Depois, escolha um framework distribuído e construa um projeto real. Não um tutorial de YouTube. Algo que resolva um problema seu de verdade. Talvez transformar logs de um site em relatórios que façam sentido. O segundo passo é entender arquitetura de dados. Lambda architecture era o padrão. Agora Kappa architecture ganhou espaço por ser mais simples. A diferença prática é que você trata tudo como streaming, sem batch separado. Funciona bem para a maioria dos casos mas não para todos. O terceiro passo é ganhar experiência prática. Contribua com projetos open source. Resolva problemas reais de empresas pequenas. Essas experiências valem mais que qualquer certificado. Eu ja vi pessoas sem certificação nenhuma serem contratadas por causa de portfólios bem construídos.
Alternativas se big data não for para você
Se o trabalho com dados distribuídos não for seu estilo, existem caminhos alternativos. Análise de dados com ferramentas como Tableau ou Power BI paga bem e tem menos complexidade técnica. Engenharia de dados focada em pipelines ETL também é uma opção que não exige conhecimento profundo de sistemas distribuídos. A decisão depende do seu perfil. Quem gosta de resolver problemas técnicos complexos deve seguir pra engenharia de dados. Quem prefere trabalhar com insights e visualização deve seguir pra análise. Ambos são caminhos válidos mas exigem conjuntos de habilidades diferentes.
Galeria
-
Especialistas em big data vivem carreira em ascensão ... -
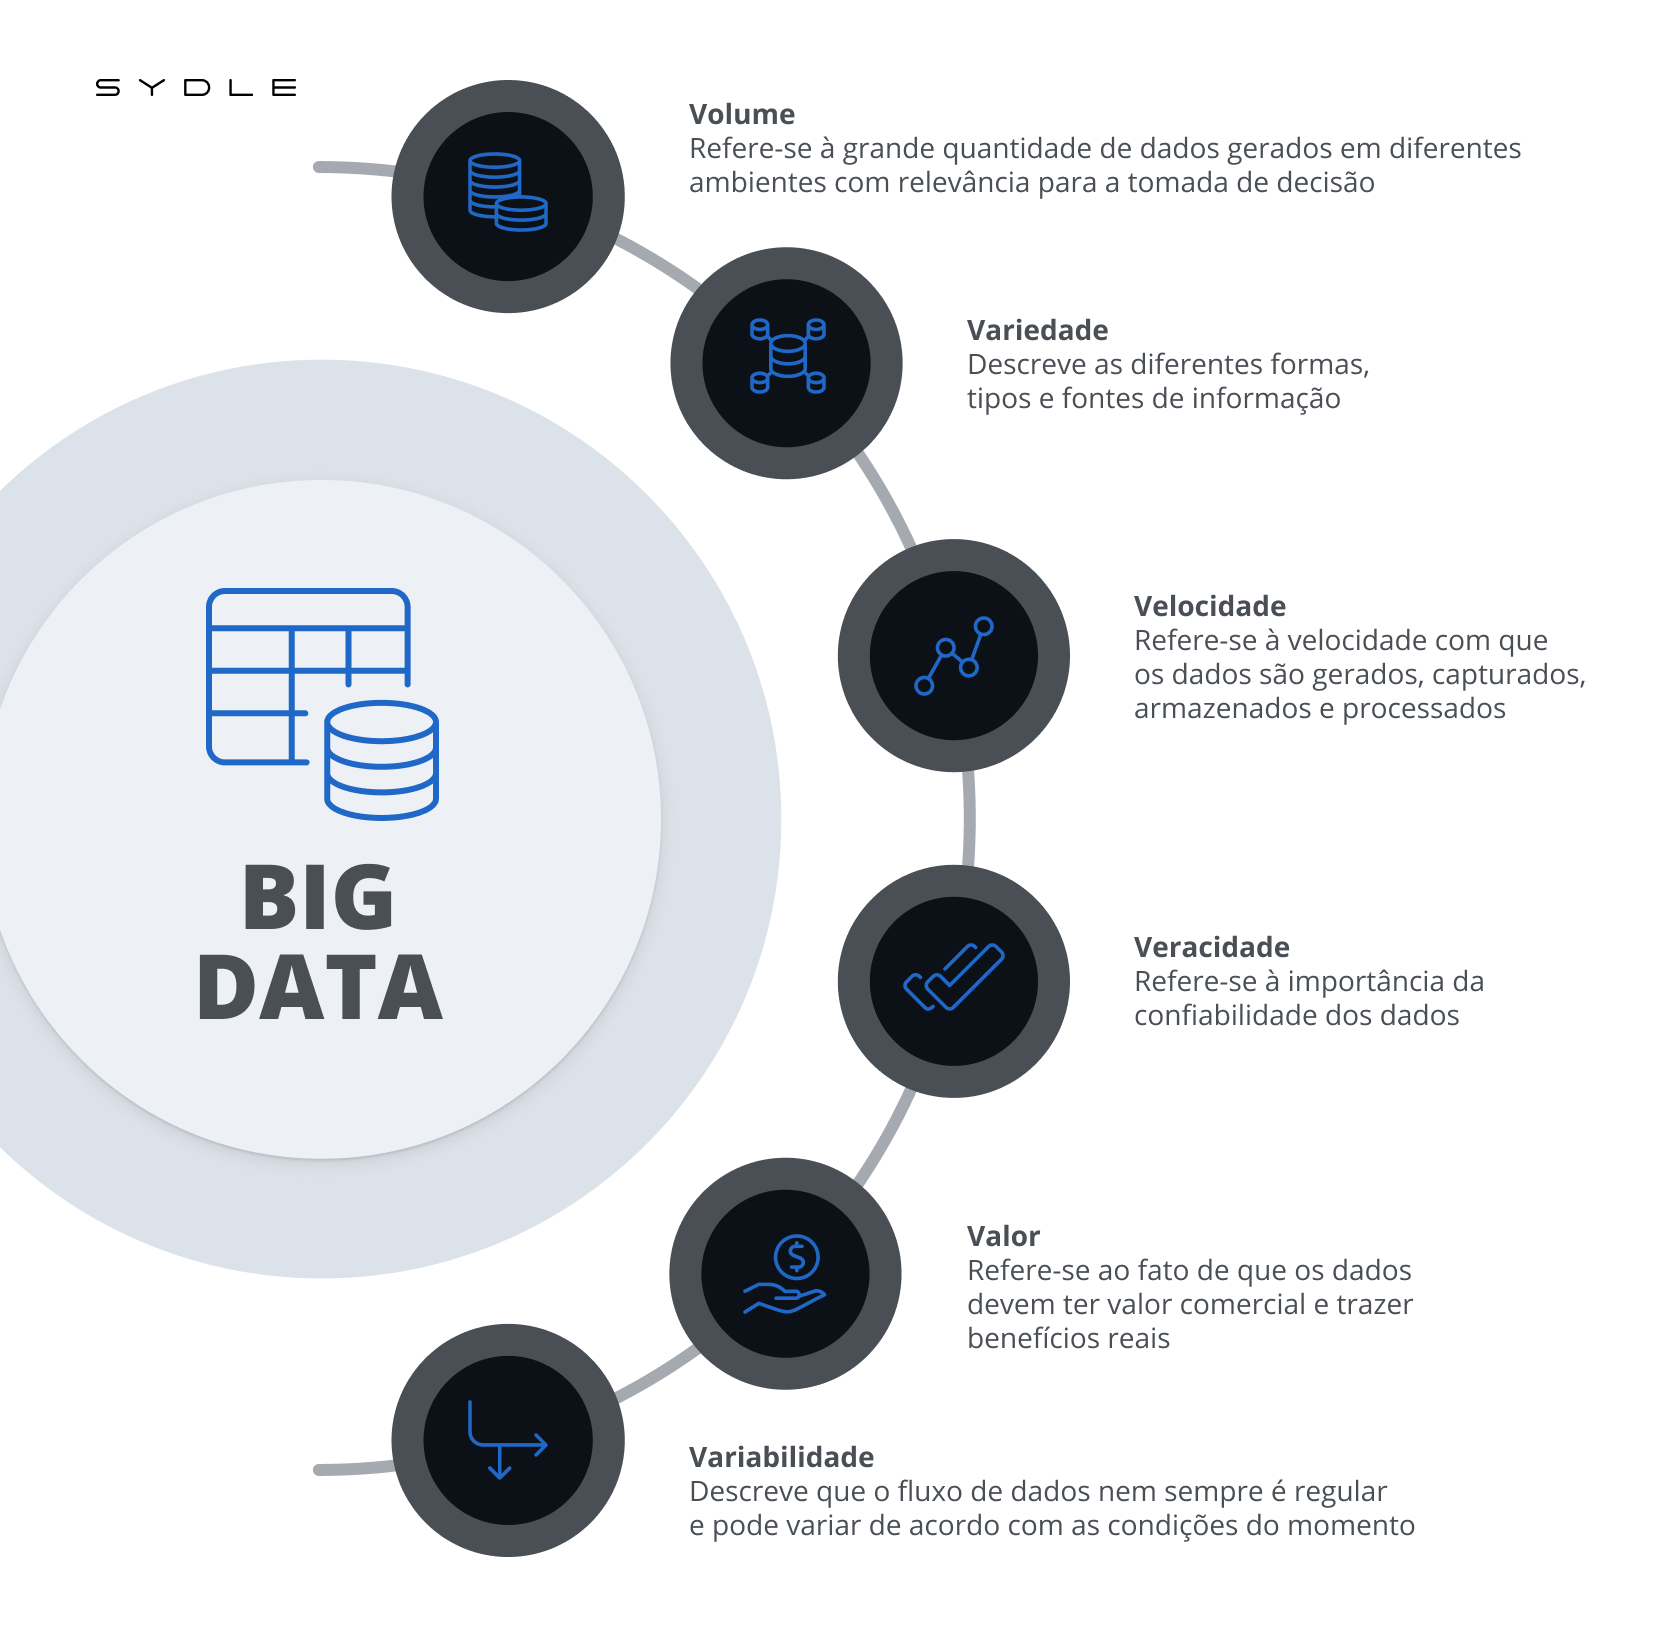
O Que Big Data E Para Que Ele Serve Marketing Por Dados Os 10 "V"s Do -

Máster en Big Data | Análisis de Datos - 【Actualizado 2026
