Linha Do Tempo Computador
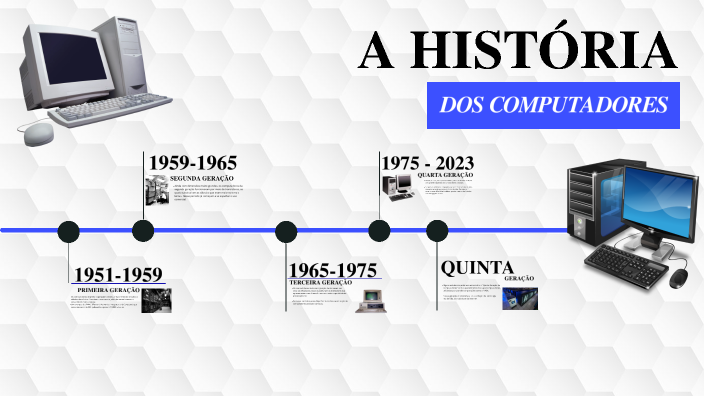
O que é e como funciona na prática
Existem várias coisas que as pessoas chamam de "linha do tempo" no contexto de computadores. A maioria delas não tem nada a ver umas com as outras, e isso já me custou horas procurando a solução errada. Vou explicar o que realmente existe, porque a internet tá cheia de informação solta sobre isso. O conceito mais útil que vejo todo dia é o histórico de eventos do sistema operacional. No Windows, isso se chama Visualizador de Eventos (eventvwr.msc). No Linux, você usa journalctl ou olha em /var/log. Essa linha do tempo computador mostra exatamente o que aconteceu no seu máquina: drivers carregando, serviços falhando, processos matando outros processos, erros de disco, tudo registrado com timestamp.
Como construir sua própria linha do tempo computador
Se você quer algo mais prático que só ler logs burritos, pode construir um registro personalizado. No Windows, o Task Scheduler permite criar tarefas que disparam em eventos específicos e você registra tudo num arquivo texto. No Linux, um script simples com cron e redirect já faz trabalho decente. Aqui vai um exemplo real do que eu uso no meu dia a dia. Criei um job no agendador de tarefas do Windows que roda a cada 5 minutos e captura o estado dos serviços críticos. O comando basicamente é algo como get-service | where {$_.Status -eq 'Stopped'} | out-file C:\logs\services_stopped.txt -append. Depois de três meses rodando, eu tenho uma linha do tempo computador completa de quando cada serviço parou e por quê. O problema é que muitos iniciantes acham que basta ligar o log e pronto. Não funciona assim. Se você não definir rotação de arquivo, em duas semanas seu disco enche. Se não filtrar eventos irrelevantes, você perde informação útil no ruído. Eu deixei um servidor rodar com logging habilitado sem configuração adequada e o disco de log chegou a 47GB em quatro dias. Ajustei para manter só warnings e errors, rotacionando semanalmente, e o consumo caiu para menos de 200MB por mês.
Outra coisa que as pessoas ignoram: a precisão do timestamp depende do sincronismo NTP. Se seu computador não estiver sincronizado com um servidor de hora confiável, toda sua linha do tempo computador fica com hora errada. Já perdi meio dia caçando um bug que parecia intermitente até descobrir que o relógio do servidor derivava 4 segundos do real. Configurei o w32tm para usar pool.ntp.org e o problema sumiu.

Pitfalls que ninguém conta
O Visualizador de Eventos do Windows esconde informações importantes por padrão. Você precisa ativar os canais analíticos e de depuração nas propriedades do log para ver o que realmente está acontecendo. Sem isso, você vê só o resumo superficial. No Linux, o mesmo problema existe com o journalctl: o sistema padrão de log não armazena histórico muito antigo se o Storage for volatile. Configurei Persistent=yes no arquivo de configuração do journald e passei a ter logs completos mesmo após reinicializações. Um problema bem específico que encontrei: programas de virtualização como VirtualBox e Hyper-V criam suas próprias linhas do tempo separadas dos eventos do sistema hospedeiro. Se você está diagnosticando uma VM que trava e só olha os logs do Windows host, vai perder tudo. A solução é ativar logging interno em cada hipervisor e cruzar os timestamps manualmente. Leva tempo, mas é a única forma de ter visão completa. A limitação mais chata de qualquer linha do tempo computador é que eventos críticos podem apagar registros anteriores. O Windows sobrescreve logs antigos quando atinge o tamanho máximo, a menos que você desative esse comportamento. Eu desativei em servidores de produção, mas em máquinas pessoais isso consome espaço desnecessariamente. Encontrar um equilíbrio depende do seu caso. Se você quer reter tudo, configure o log para "Não substituir eventos" e monitore o tamanho periodicamente.
Alternativas quando o método padrão falha
Quando o log do sistema operacional não é suficiente, existem ferramentas de terceiros. No Windows, o Process Monitor do Sysinternals captura absolutamente tudo que um processo faz: leituras de arquivo, chamadas de registry, operações de rede. O problema é que a quantidade de dados é absurda — uma sessão de teste de 10 minutos gera milhões de linhas. Filtros rigorosos são obrigatórios. No Linux, ferramentas como strace e ltrace oferecem profundidade similar, mas com impactoperformance significativo. Não recomendo rodar em produção sem saber o que está fazendo. Já vi um administrador rodar strace em um serviço de banco e gerar tanto overhead que o próprio serviço ficou inutilizável durante o diagnóstico. Se o objetivo é apenas monitoramento contínuo e alertas, talvez uma linha do tempo computador personalizada não seja a melhor solução. Sistemas como Zabbix, Prometheus com Grafana, ou até um ELK Stack simples resolvem o problema de forma mais escalável. A desvantagem é que exigem configuração inicial e manutenção, o que nem sempre compensa para uso pessoal.
Resumo prático
O que funciona na minha experiência é combinar três camadas: logs do sistema operacional com retenção configurada, um job agendado capturando estados periódicos, e filtros rigorosos desde o início. Gasta cerca de 30 minutos para montar a estrutura inicial, mas economiza horas de investigação quando algo dá errado. A linha do tempo computador não resolve problemas sozinha, mas ter dados históricos organizados é o mínimo que um administrador responsável deve manter disponível.

Galeria
-
Linha do Tempo da Evolução do Computador | PDF | Equipamento | Eletrônicos -
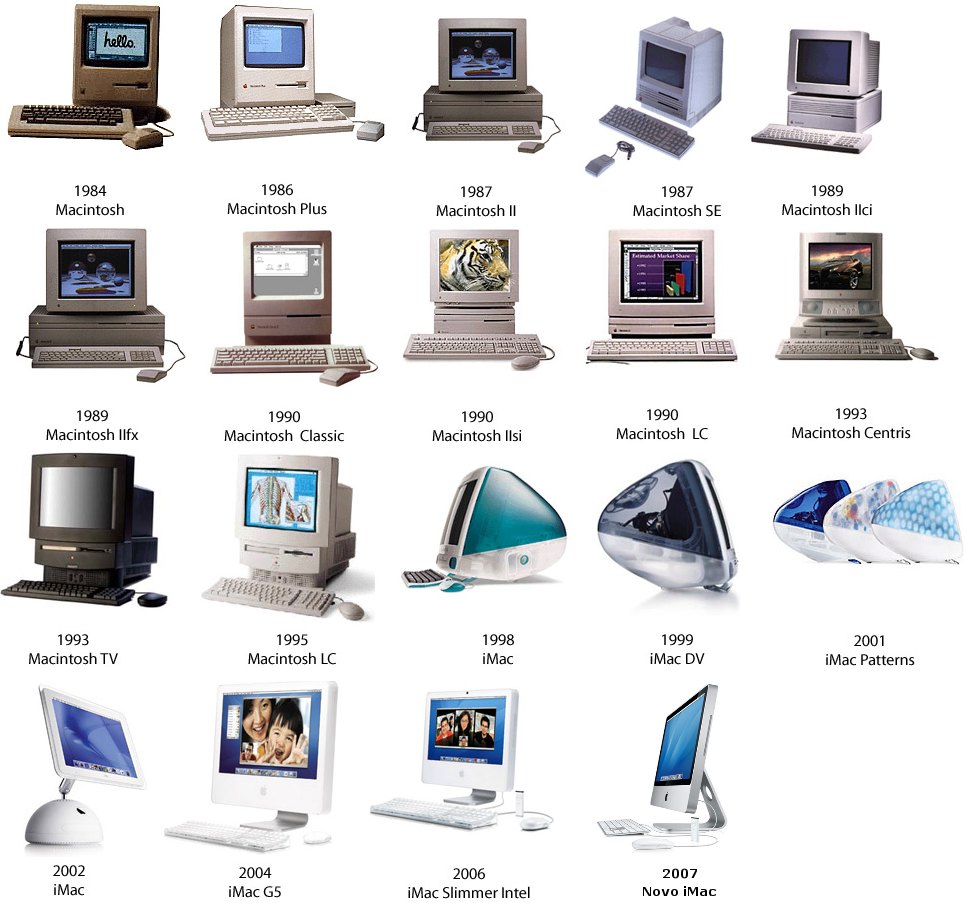
Linha Do Tempo Computador - ZULEDU -

Historia Da Linha Do Tempo Do Computador, Do Abaco Ao Presente

