Criando uma lista de palavras complexas que funciona na prática
O primeiro erro que eu via todo mundo cometer era tentar importar listas prontas da internet. A maioria dessas bibliotecas são coletadas de fontes genéricas e não refletem o vocabulário real do usuário. Eu descobri isso depois de perder três dias tentando treinar um modelo com uma lista de 4 mil termos que eu tinha baixado de um repositório qualquer. O resultado foi um ruído tão alto que tivemos que largar o projeto e reconstruir do zero.
A solução que eu achei foi extremamente prática: pegar textos reais do seu domínio de trabalho, extrair palavras que aparecem com frequência moderada (nem muito comuns, nem muito raras) e construir a partir daí. O processo leva em torno de 45 minutos para uma lista inicial de 800 a 1.200 termos, dependendo do volume de texto disponível.
Processo de extração para sua lista de palavras complexas
Eu começava rodando um script Python simples que lê os arquivos .txt ou .pdf da área, aplica tokenização básica, remove stopwords do português e conta a frequência de cada termo. Depois eu filtrava as palavras com frequência entre 10 e 500 ocorrências — essas são as que carregam informação técnica sem serem obscenas. O filtro é arbitrário mas funciona como ponto de partida razoável.
O problema é que frequência alta não significa utilidade. Uma palavra pode aparecer 300 vezes e ser completamente inútil para aprendizado ativo porque todo mundo já sabe usá-la. Por isso eu aplicava um segundo filtro: verificar a distribuição de contexto. Se uma palavra aparecia em menos de três sentidos diferentes nos textos, eu cortava. Palavras polissêmicas são muito mais ricas para estudo.
Eu também adicionava manualmente cerca de 15% dos termos que eu sabia que o público-alvo precisava dominar, mas que apareciam tão raramente no corpus que o script natural nunca os capturaria. Isso exigia conhecer o domínio — não adianta tentar fazer isso sem experiência prévia no assunto que você está tratando.
Estruturação dos dados
Cada entrada na sua lista de palavras complexas precisa ter pelo menos: a palavra em si, a classe gramatical, o registro (formal, técnico, literário, coloquial), a definição ou sinônimos equivalentes, e exemplos extraídos diretamente dos textos originais. Você pode montar isso num arquivo CSV simples ou num JSON estruturado. Eu prefiro JSON porque permite aninhamento de subcampos quando o termo tem múltiplas acepções.
O detalhe que as pessoas esquecem é a normalização ortográfica. Palavras com acentuação variante, hífen e novas regras ortográficas geram duplicações silenciosas que destroem estatísticas. Um passo de normalização com regras de mapeamento pré-definidas (há tabelas públicas de equivalências do Acordo Ortográfico) resolve isso em minutos.
Pegadinhas que ninguém conta
A primeira é sobre homônimos. A palavra "banco" aparece no corpus e o algoritmo vai tratar como se fosse só o instituinte financeiro, ignorando completamente o assento e a instituição de ensino. Você precisa marcar essas ocorrências manualmente ou rodar um disambiguador. Leva tempo extra, mas evita viés severo nos dados.
A segunda é mais sutil: palavras compostas. "Alta complexidade" pode ser tratada como duas palavras separadas, mas semanticamente funciona como uma unidade. Decidir quando juntar ou separar depende do objetivo. Para aprendizado de línguas, manter separado costuma ser mais útil. Para análise de domínio técnico, compostos fixos devem ser tratados como tokens únicos.
O limite do método
Essa abordagem tem um problema séria: ela só funciona bem se você tiver corpus suficiente — pelo menos 50 mil palavras processadas, idealmente 200 mil. Com menos que isso, a estatística de frequência fica instável e você acaba capturando ruído como se fosse sinal. Se o seu corpus for pequeno, o caminho alternativo é usar listas de referência validadas academicamente, como o Corpus Brasileiro de Português ou o CEBRA, e enriquecê-las com termos específicos do seu domínio.
Outro ponto fraco é a manutenção. Uma lista construída assim precisa de revisão periódica, porque o vocabulário técnico evolui — novos termos entram, velhos saem de uso. Eu via equipes esquecerem disso e continuarem usando listas obsoletas por anos. Recomendo um ciclo de atualização trimestral com varredura dos novos textos produzidos no período.
Alternativas quando o método não serve
Se você não tem corpus próprio ou tempo para construir manualmente, existem listas de palavras complexas disponíveis em repositórios acadêmicos e plataformas de ensino. O inconveniente é que elas são genéricas e não mapeiam o vocabulário específico que o seu grupo precisa. O equilíbrio ideal é usar uma base pública como esqueleto e adicionar camadas customizadas por cima.
O custo de manter essa versão híbrida é cerca de 20% do tempo que você gastaria construindo tudo do zero, e a qualidade final costuma superar significativamente uma lista 100% genérica, principalmente em domínios especializados como direito, medicina ou engenharia.
Galeria
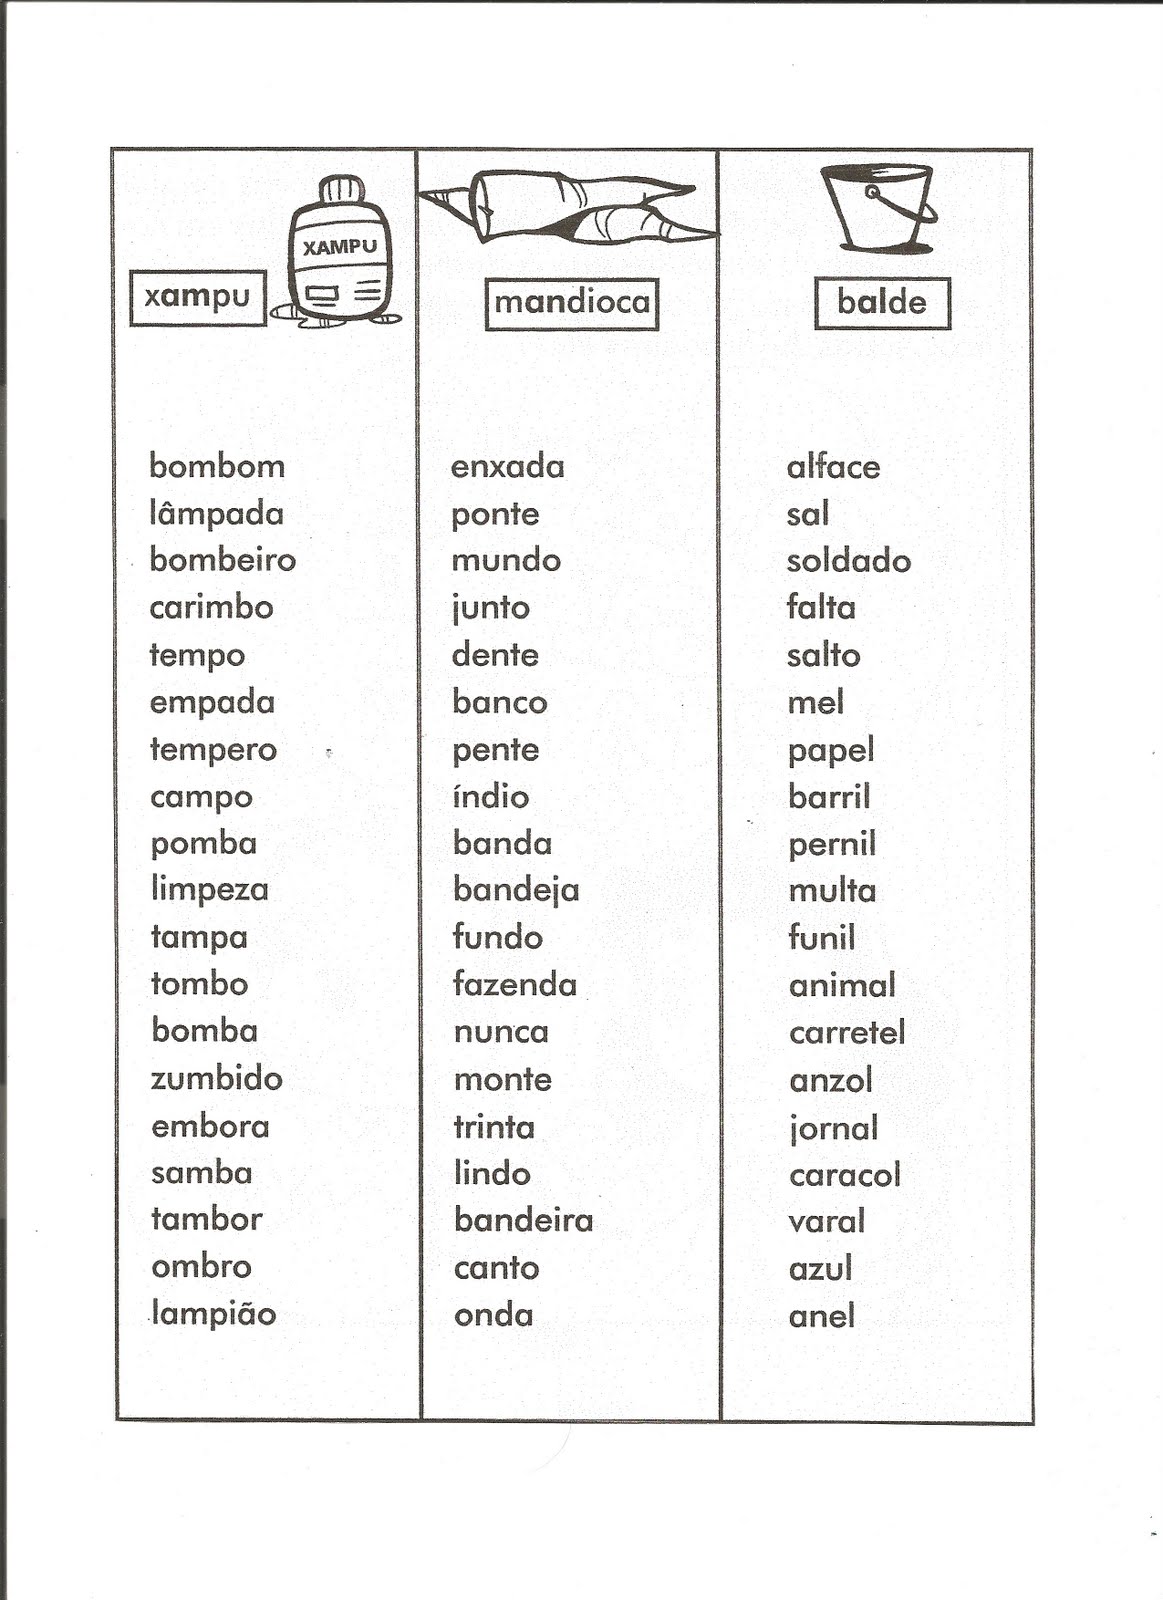
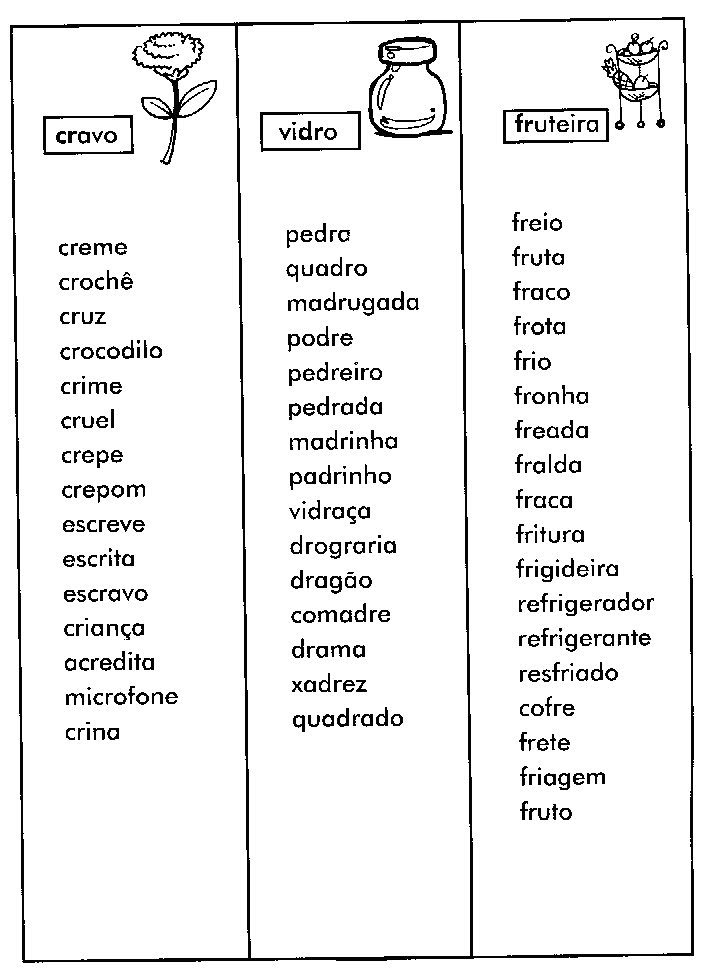
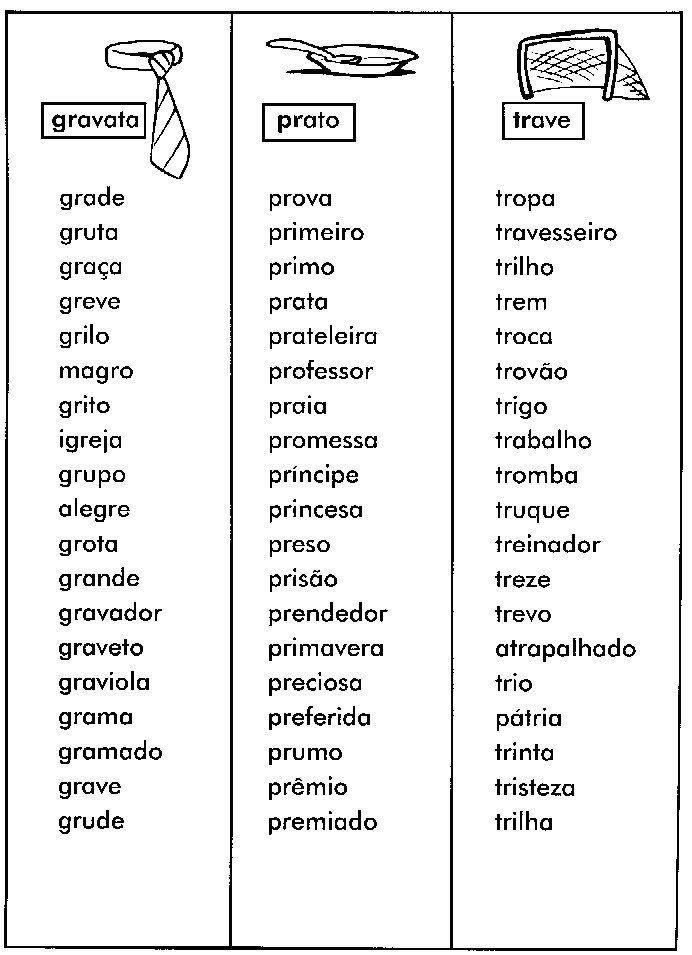
Lista De Palavras Com Silabas Complexas - FDPLEARN
Pedagogas da paz: Lista de palavras com sílabas complexas - Ficha de ...
Pedagogas da paz: Lista de palavras com sílabas complexas - Ficha de ...
Lista De Palavras Complexas - NAZAEDU
Pedagogas da paz: Lista de palavras com sílabas complexas - Ficha de ...