O Que Protocolo De Rede

Entendendo como os pacotes chegam de um ponto a outro
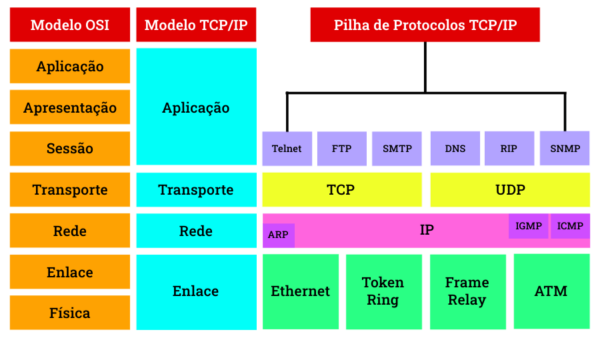
Você já tentou fazer uma videoconferência e o áudio cortava enquanto o vídeo continuava liso? Ou já viu uma transferência de arquivo que travava em 99% porque o checksum falhou? Isso acontece por causa de protocolos de rede. O conceito em si é simples, mas a implementação é onde as coisas dão errado na prática. Protocolo de rede é um conjunto de regras que define como dados são formatados, transmitidos, recebidos e interpretados entre dispositivos. Sem essas regras, cada fabricante faria do seu jeito e nada se comunicaria. O TCP, o UDP, o IP, o HTTP, o DNS — todos são protocolos com responsabilidades diferentes. O IP endereça e roteia. O TCP garante entrega ordenada. O UDP manda e torce. O DNS traduz nomes em IPs. Cada um opera em uma camada diferente do modelo OSI, mas na hora que algo quebra, você não pensa em camadas, pensa em logs. Uma coisa que muita gente não leva a sério é o MTU. A maioria dos provedores ainda usa 1500 bytes como padrão em Ethernet, mas quando você entra em VPNs, tunéis ou links MPLS, o caminho pode ter um MTU menor. Se o pacote vier maior que o dispositivo intermediate consegue passar, ele é fragmentado ou descartado. Eu passei duas semanas investigando por que um cliente tinha perda intermitente de pacotes em uma conexão site-to-site VPN. O sintoma era estranho: ping funcionava, mas transferências grandes travavam. O problema era que o MTU do túnel IPSec estava em 1476, mas o caminho todo via uma interface com MTU 1400. Pacotes de 1500 chegavam no roteador de borda, eram fragmentados, e fragmentos perdidos causavam retransmissões silenciosas do TCP. A solução foi configurar o TCP MSS clamping para 1340 na borda do túnel. Funcionou na hora, mas o diagnóstico levou dias porque o sintoma não apontava para latência nem para perda de link — apontava para algo que parecia funcionar até não funcionar.
Como funciona na real
Quando você envia um dado pela rede, ele passa por várias camadas de encapsulamento. Aplicações geram payload, que é empacotado por protocolos de transporte como TCP ou UDP, que por sua vez recebem cabeçalhos de IP. Esse pacote vai para a camada de enlace, que adiciona endereços MAC e verificações de integridade. Cada salto pela rede, o roteador lê o cabeçalho IP, consulta a tabela de roteamento e encaminha o frame para a próxima interface. No destino, o processo se inverte: cada camada remove seu próprio cabeçalho e passa os dados para a camada seguinte. O handshake TCP de três vias é um dos mecanismos mais conhecidos. SYN, SYN-ACK, ACK. Sem isso, não há conexão estabelecida. Mas o que pouca gente sabe é que esse handshake pode ser explorado de formas que travam servidores inteiros. Floods SYN consomem tabelas de conexão no servidor de destino. Por isso existam firewalls com stateful inspection e técnicas como SYN cookies. Em produção, eu vi um servidor rodando sob ataque DDoS layer 7 que parecia um problema de aplicação, mas na verdade era um excesso massivo de handshakes TCP maliciosos saturando a pilha de rede. O workaround foi configurar rate limiting no iptables com hashlimit e habilitar SYN cookies no kernel. Resolveu em minutos.
Problemas comuns que ninguém comenta
TCP retx é um dos maiores vilões de performance que você raramente vê sendo discutido abertamente. Quando um pacote é perdido, o TCP entra em congestionamento e reduz a janela. A recuperação é lenta. Em links com alta latência, mesmo uma perda de 0,1% de pacotes pode reduzir drasticamente a throughput. O BBR do Linux, desenvolvido pelo Google, é uma alternativa ao TCP cubic tradicional que tenta mapear melhor a banda disponível e a RTT. Em testes práticos, migrei um serviço de alta latência (RTT de 200ms) do cubic para o BBR e vi ganho de 40% em throughput. A configuração é uma linha no sysctl: net.ipv4.tcp_congestion_control=bbr. Fácil, mas o efeito não é óbvio para quem nunca mediu. Outro problema crônico é DNS caching inadequado. Muitos scripts e aplicações resolvem endereços DNS a cada requisição em vez de cachejar localmente. Isso gera overhead desnecessário, especialmente em ambientes com muitas micro-solicitações. O dnsmasq ou o systemd-resolved resolvem isso configurando TTLs curtos mas com cache ativo. Em um ambiente com 500 hosts fazendo requisições DNS simultâneas, a diferença entre resolver tudo na nuvem e cachejar localmente é a diferença entre 50ms e 5ms de latência por query. O ARP cache também é uma fonte silenciosa de problemas. Spoofing de ARP pode redirecionar tráfego para um equipamento malicioso na mesma sub-rede. Em redes corporativas, o Dynamic ARP Inspection (DAI) nos switches é essencial para mitigar isso. Sem ele, qualquer pessoa com acesso físico ou lógico à VLAN pode fazer um arp spoof e realizar um MITM. Eu já vi isso acontecer em uma rede de teste onde um colega configurou um script Python com scapy para demonstrar o ataque. Em 30 segundos, todo o tráfego da VLAN passou pelo computador dele. O fix foi configurar DAI com binding estático de ARP nos switches de acesso.

Quando protocolos falham completamente
Não adianta romantizar. Protocolos de rede têm limites claros. O TCP é otimizado para dados confiáveis, mas péssimo para tempo real. Streaming de vídeo ao vivo e voip usam UDP justamente porque a latência do TCP é intolerável. Você prefere perder alguns frames do que esperar retransmissões. O trade-off é claro, mas muitos engenheiros inexperientes tentam forçar TCP onde UDP deveria ser usado. Protocolos como FTP são obsoletos em praticamente todos os contextos modernos. Eles usam canais separados para controle e dados, o que quebra atrás de NAT e firewalls com facilidade. O SFTP ou o SCP são alternativas amplamente adotadas. O FTPS existe, mas raramente é a escolha certa em ambientes cloud-native. O IPv6 ainda enfrenta resistência pratica. Embora o endereçamento seja generoso e a segurança seja intrínseca com IPsec, a transição é dolorosa. Muitos equipamentos legados não suportam IPv6 nativamente, e a dual-stack adiciona complexidade de configuração. Em um projeto recente, precisei garantir que um sistema legado suportasse IPv6 em produção. A solução foi colocar um proxy reverso com suporte a ambas as versões nas camadas de fronteira e manter o IPv4 interno. Resolveu, mas adicionou um ponto único de falha que exigia redundância imediata.
O que observar antes de configurar qualquer coisa
Antes de mexer em protocolos, entenda o que o sistema já faz por padrão. O Linux tem configurações de rede otimizadas para datacenter que podem melhorar performance significativamente. O tuning de TCP buffer sizes, o uso de TCP timestamps para medição precisa de RTT, e o ajuste de RTO minimum são tweaks que não aparecem em tutoriais básicos mas fazem diferença real. O script tcpkali para benchmark de throughput TCP é uma ferramenta útil para validar alterações antes de aplicá-las em produção. Wireshark continua sendo a ferramenta mais confiável para diagnose. Capture, filtre por IP de origem ou destino, inspecione o handshake, verifique retransmissões, analise window scaling. Em 90% dos casos, a resposta está nos pacotes capturados, não em suposições. Eu gastei três dias tentando diagnosticar uma queda de throughput que só acontecia em horários de pico. O problema era Nagle's algorithm interagindo mal com a bufferização do switch. Desligar o TCP_NODELAY no lado do cliente resolveu. Sem wireshark, jamais teria chegado lá. Documentação oficial de RFCs é acessível e essencial. A RFC 793 descreve o TCP, a RFC 791 o IP, a RFC 1035 o DNS. Ler as RFCs originais dá uma compreensão que documentação de terceiros nunca oferece. Não precisa ler todas, mas consultar as relevantes para o problema que você está enfrentando acelera muito o diagnóstico.
Erros que vejo todos os dias
Atribuir problemas de aplicação a protocolos sem verificar a camada de aplicação primeiro. Antes de culpar o TCP por lentidão, verifique se a query no banco de dados não está retornando milhões de linhas. Protocolos de rede geralmente funcionam como especificados. O problema está em como são usados, não no protocolo em si. Configurar firewalls sem entender stateful inspection. Bloquear portas é fácil. Entender o estado das conexões e permitir apenas tráfego legítimo requer conhecimento de como o TCP handshake funciona e como os filtros de estado rastream a sessao. Regras mal configuradas podem bloquear conexões legítimas ou abrir brechas perigosas. Teste sempre com uma VM isolada antes de aplicar em produção. Ignorar a seção de checksum em diagnósticos. Erros de checksum aparecem em interfaces de rede sobrecarregadas ou com hardware defeituoso. Se você vê checksum errors crescendo no ifconfig ou em ip -s link, verifique cabos, SFPs, e configurações de offloading. checksum offloading no NIC pode causar problemas em algumas situações, especialmente com VPNs. Desabilitar temporaáriamente o offloading e testar pode revelar se o hardware de rede é a causa raiz.

Protocolos de rede são a base de tudo. Funcionam quase sempre. Quando falham, o diagnóstico exige paciência, ferramentas adequadas e experiência prática. A teoria é simples. A prática é onde os problemas aparecem e onde as soluções são construídas.
Galeria
-
Protocolos das camadas do Modelo OSI. O Que São Protocolos de Rede ... -
Protocolos de Rede: Arquitetura, Funcionamento e Aplicações -
Protocolos de comunicação de rede: saiba sua importância


