O Que Significa Conjuntos

Conjuntos são estruturas de dados que armazenam elementos únicos
O conceito de conjunto existe tanto na matemática discreta quanto na programação. Na prática, é uma coleção onde cada item aparece apenas uma vez, independente de quantas vezes você tentar adicionar o mesmo valor. Isso parece simples, mas gera confusão frequente porque muitas pessoas chegam nesse tópico sem entender as implicações de unicidade e a diferença para outras estruturas. Vou explicar do jeito que eu uso no dia a dia, com exemplos reais de código e os problemas que realmente importam.
O que significa conjuntos na prática
Em Python, o tipo set é implementado como uma tabela hash. Isso significa que operações de busca, inclusão e remoção são geralmente O(1) no caso médio, muito mais rápido que verificar cada elemento de uma lista sequencialmente. Em Java, temos HashSet, codeTreeSet e codeLinkedHashSet — cada um com tradeoffs específicos. Em JavaScript, desde ES2015, o objeto Set também segue a lógica de valores únicos com complexidade O(1) para adição e verificação de presença. A implementação por hash table tem uma consequência importante que ninguém menciona suficiente: ordenação não é garantida. Um conjunto que você popula com [3, 1, 2] pode ser iterado na ordem [1, 3, 2] ou qualquer outra. Se você precisa de ordem, use sorted(set(x)) no Python, ou TreeSet no Java, que mantém os elementos ordenados via árvore rubro-negra — mas isso transforma a complexidade de O(1) para O(log n) em todas as operações. Outro ponto que causa erro: conjuntos só aceitam elementos imutáveis (hashable). Você não pode colocar uma lista dentro de um set. Tentar fazer set([[1, 2], [3, 4]]) em Python gera um TypeErrortraceback direto. A solução é converter para tupla primeiro: set([tuple(i) for i in [[1, 2], [3, 4]]]). Eu perdi duas horas num projeto de ETL porque não pensei nisso. Os dados vinham de um CSV como listas aninhadas, e meu script quebrava silenciosamente em produção porque a exceção era capturada numa camada mais acima e o job simplesmente não processava a partição correspondente.
Operações fundamentais
As quatro operações básicas que você vai usar o tempo todo são união, interseção, diferença e diferença simétrica. Em Python, os operadores são | (união), & (interseção), - (diferença) e ^ (diferença simétrica). Em Java, você chama métodos como union(), retainAll(), removeAll() e difference() — embora esta última só exista a partir do Java 21 via Stream API. Um detalhe prático que pouca gente considera: quando você faz interseção entre dois sets grandes, o resultado pode ser significativamente menor que ambos os operandos. Se seu objetivo é encontrar elementos comuns em datasets massivos, considere usar bitsets (conjuntos de bits) em vez de sets de objetos. Um BitSet do Java ou um array de bits em C++ pode conter milhões de inteiros em poucos megabytes de memória, enquanto um HashSet<Integer> com o mesmo conteúdo consumiria centenas de megabytes devido à sobrecarga de boxing e referências de objeto. Para uniões repetidas em loops, evite criar novos sets a cada iteração. Em Python, o método update() modifica o set original em lugar, economizando alocações. Em Java, addAll() também é in-place. A diferença de performance é insignificante para sets pequenos, mas em pipelines que processam milhões de registros por segundo, isso se acumula rapidamente.

Diferença entre conjuntos e outras estruturas
Um erro comum é tratar conjuntos como listas com duplicatas removidas. Eles não são. Listas preservam ordem e permitem duplicatas. Conjuntos eliminam duplicatas e não preservam ordem (a menos que usem uma implementação ordenada). Dicionários têm pares chave-valor. Conjuntos são apenas chaves, sem valores associados. Se você precisa de uma coleção com ordem e sem duplicatas, o caminho é usar um set para filtragem e depois ordenar o resultado, ou usar OrderedSet de bibliotecas de terceiros como o ordered-set no Python. Não existe no padrão da linguagem, e a ausência desse tipo na biblioteca padrão é algo que frustrou muitos desenvolvedores, incluindo eu, em vários projetos.
Quando conjuntos não funcionam bem
Conjuntos baseados em hash têm um problema conhecido: colisão de hash. Se seu dataset contém muitos elementos que geram o mesmo código de hash (por exemplo, strings com padrões similares em algoritmos de hash fracassados), a complexidade degrada de O(1) para O(n). Em Python, isso é raro porque o algoritmo de hash de strings é robusto. Em Java, strings também têm hash memoizado e bem distribuído. O risco real aparece com objetos customizados cujas classes hashCode() e equals() não estão implementadas corretamente. Se você cria uma classe Pessoa e adiciona instâncias a um HashSet sem sobrescrever esses dois métodos, o comportamento será baseado na identidade do objeto (endereço de memória), não nos atributos — e você terá duplicatas que parecem idênticas. Outra limitação séria: conjuntos não suportam indexação por posição. Não existe set[0]. Se você precisa acessar o n-ésimo elemento, precisa converter para lista ou iterar até ele, o que é O(n). Para acesso aleatório frequente, um array ou lista é mais adequado. Memória também é um fator. Cada elemento em um HashSet em Java carrega overhead de nó da tabela hash, referência de chaining e possivelmente pointers de red-black tree se for TreeSet. Em Python, cada string em um set além do conteúdo em si consome aproximadamente 50-60 bytes extras de metadata. Para 10 milhões de strings curtas, isso pode significar centenas de megabytes a mais do que você espera pelo tamanho bruto dos dados.
Exemplo prático de uso real
Num sistema de recomendação que construí para um e-commerce, usei conjuntos para calcular a interseção de categorias entre usuários. A lógica era simples: dado um usuário, encontrar outras pessoas que compartilhassem pelo menos 3 categorias de produtos. Cada usuário era representado como um set de IDs de categoria. A interseção entre sets é a operação central ali. O problema surgiu quando o volume cresceu. Sets com milhares de categorias cada tornaram as interseções lentas. A solução foi implementar SimHash como aproximação — uma técnica que transforma sets em hashes fixos de 64 bits, onde a similaridade de Jaccard (tamanho da interseção dividido pelo tamanho da união) pode ser estimada através da distância de Hamming entre hashes. Não é exato, mas reduz o tempo de cálculo de segundos para milissegundos por par de usuários, com margem de erro aceitável para o caso de uso. Se seu problema é pequeno — menos de mil elementos por conjunto, menos de cem conjuntos — conjuntos normais resolvem perfeitamente. A otimização prematura com simhash e técnicas aproximadas só se justifica em escala real. Meus sets cabiam na memória RAM sem problema, então não precisei recorrer a estruturas externas ou indexação invertida.

Código de exemplo
No Python, a sintaxe é direta: frutas = {"maçã", "banana", "laranja"}
outras_frutas = {"uva", "banana", "pera"}União
todas_as_frutas = frutas | outras_frutas {'maçã', 'banana', 'laranja', 'uva', 'pera'}
Interseção
comuns = frutas & outras_frutas  {'banana'}
Diferença (o que está em frutas mas não em outras_frutas)
somente_frutas = frutas - outras_frutas {'maçã', 'laranja'}Verificar pertinência — O(1)
"maçã" in frutas True
Remover duplicatas de uma lista Em Java:
lista_com_duplicatas = [1, 2, 2, 3, 4, 4, 5]
sem_duplicatas = list(set(lista_com_duplicatas)) Ordem não garantidaSet
Set

// União
frutas.addAll(outrasFrutas);
// Interseção
frutas.retainAll(outrasFrutas); // frutas agora é apenas {"banana"}// Diferença
frutas.removeAll(outrasFrutas);
O conceito de conjunto é simples na definição, mas as nuances de performance, memória e implementações específicas fazem toda a diferença quando você sai dos tutoriais e entra em produção. A maioria dos problemas que eu vejo surgem de expectativas erradas sobre ordenação e hashability, não da teoria em si.
Galeria
-

Mapa Mental De Conjuntos - NAZAEDU -
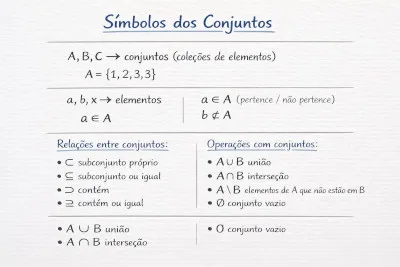
Símbolos dos Conjuntos - CalculandoTudo
