Palavras Para Formar Frases

O que é e como funciona
A ferramenta de palavras para formar frases basicamente pega uma sequência ordenada de termos e os embaralha automaticamente. O objetivo do usuário é recolocar tudo na ordem correta. Parece simples porque é, na prática, uma mecânica muito direta de drag-and-drop ou clique para reordenar. Mas existem alguns detalhes que todo mundo ignora até dar pau no meio de um exercício maior. O problema principal não é o conceito em si. É a forma como os algoritmos lidam com pontuação, contrações e variações de capitalização. Eu estava montando um quiz para alunos de nível intermediário quando percebi que o sistema estava marcando respostas certas como erradas. A frase original era "Onde você estuda?" e o usuário digitou "onde você estuda" sem interrogação e com letra minúscula. O sistema rejeitou. Não porque estava errado gramaticalmente, mas porque a comparação era case-sensitive e ignorava sinais de pontuação. A solução que eu encontrei foi criar uma função de normalização antes do julgamento. Basically, remover pontuação, converter tudo para minúsculas e stripping de espaços extras. Depois disso, a comparação vira uma verificação pura de tokens na ordem correta. Isso resolveu 90% dos falsos positivos que eu estava tendo.
Outro detalhe que as ferramentas prontas geralmente não mencionam: a ambiguidade sintática. Frases como "Vi o homem com o binóculo" podem ter duas estruturas parses diferentes dependendo de como você interpreta o sintagma preposicional. Se o embaralhador não respeita grupos sintáticos, ele vai gerar permutações que linguisticamente não fazem sentido algum, e o usuário simplesmente vai travar achando que o exercício está quebrado.
Como implementar do zero
Você não precisa de uma biblioteca pesada. Um script básico em Python resolve em meia hora. A lógica central envolve três etapas: tokenização, embaralhamento controlado e validação. Tokenização — Divida a frase original em unidades menores. Pode ser por espaço mesmo se o português for seu único foco, mas se quiser lidar com casos mais complexos como "estão-me" ou "boletim-abaixo", aí recomenda-se um tokenizer como o spaCy configurado para português. O spaCy reconhece os morfemas e mantém a integridade das contrações. Embaralhamento controlado — Aqui é onde a maioria erra. Não embaralhe todos os tokens de uma vez. Se você tem 12 palavras e faz Fisher-Yates aleatório puro, a chance do aluno acertar de primeira é de 1 em 479 milhões. Isso não é um exercício, é loteria. O jeito certo é limitar o raio de deslocamento. Por exemplo, permita que cada palavra migre no máximo 3 posições para esquerda ou direita. Isso gera uma configuração desafiadora mas resolvível em 2 a 3 minutos, que é o tempo ideal para manter o fluxo cognitivo sem frustração.

Validação — Após a normalização que eu descrevi acima, compare o array de tokens reorderados com o array original. Se forem idênticos, acerto. Senão, erro. Você pode adicionar feedback parcial mostrando quantos tokens já estão na posição correta, o que ajuda o aluno a manter o rumo.
Dicas práticas que ninguém conta
A primeira é sobre a densidade de vocabulário. Se você usar frases muito curtas com poucas palavras, o embaralhamento não oferece desafio suficiente. Frases com 5 a 8 tokens são o ponto ideal. Menos que isso vira adivinhação. Mais que 10 e o tempo de resolução dispara, o que quebra a dinâmica de sala de aula. A segunda é sobre gênero e número. O português tem concordância verbal e nominal que cria restrições fortes. Se o sistema permitir qualquer permutação livre, ele vai produzir sequências grammaticalmente impossíveis como "os crianças estão bonito". Recomendo filtrar as permutações geradas aplicando regras mínimas de colocação: adjetivo depois de substantivo, verbo antes do sujeito em frases declarativas, e assim por diante. Isso mantém o exercício realista. Um terceiro ponto: a dificuldade progressiva. Comece com frases no presente do indicativo, depois embaralhe no pretérito, e só então introduza subjuntivo e orações subordinadas. A curva de dificuldade precisa ser gradual, senão o aluno desiste na segunda questão.
Alternativas e limitações
Se você não quer programar nada e só precisa de algo pronto para usar, existem plataformas como LearningApps, Wordwall e LanguaguReact que oferecem geradores prontos. Elas funcionam bem para uso esporádico, mas têm limitações sérias: não permitem customização fina da taxa de embaralhamento, não exportam seus exercícios para LMS, e geralmente travam com 30 ou mais itens simultâneos. Para uso profissional recorrente, o custo de manutenção nessas plataformas acaba sendo maior do que construir sua própria versão. Também é importante reconhecer que esse tipo de exercício tem um teto utilitário. Ele é bom para fixação de estrutura sintática e vocabulário básico. Não é adequado para ensinar nuance pragmática, registro formal versus informal, ou variedades dialectais. Um aluno que domina palavras para formar frases ainda pode ter dificuldade séria ao produzir linguagem espontânea em contexto real. O exercício treina reconhecimento de ordem, não competência comunicativa completa. Para quem quer ir além, o próximo passo natural é combinar com produção livre: pedir para o aluno reescrever a frase em outra pessoa verbal, ou transformar uma afirmativa em interrogativa. Assim o exercício deixa de ser puramente mecânico e passa a envolver processamento linguístico de nível mais alto.

O código-fonte do exemplo que eu mencionei está disponível num repositório público. A estrutura é intencionalmente simples para que qualquer pessoa consiga adaptar para o próprio contexto. Não tem interface gráfica, apenas a lógica central. Quem quiser algo mais elaborado pode expandir a partir daí.
Galeria
-
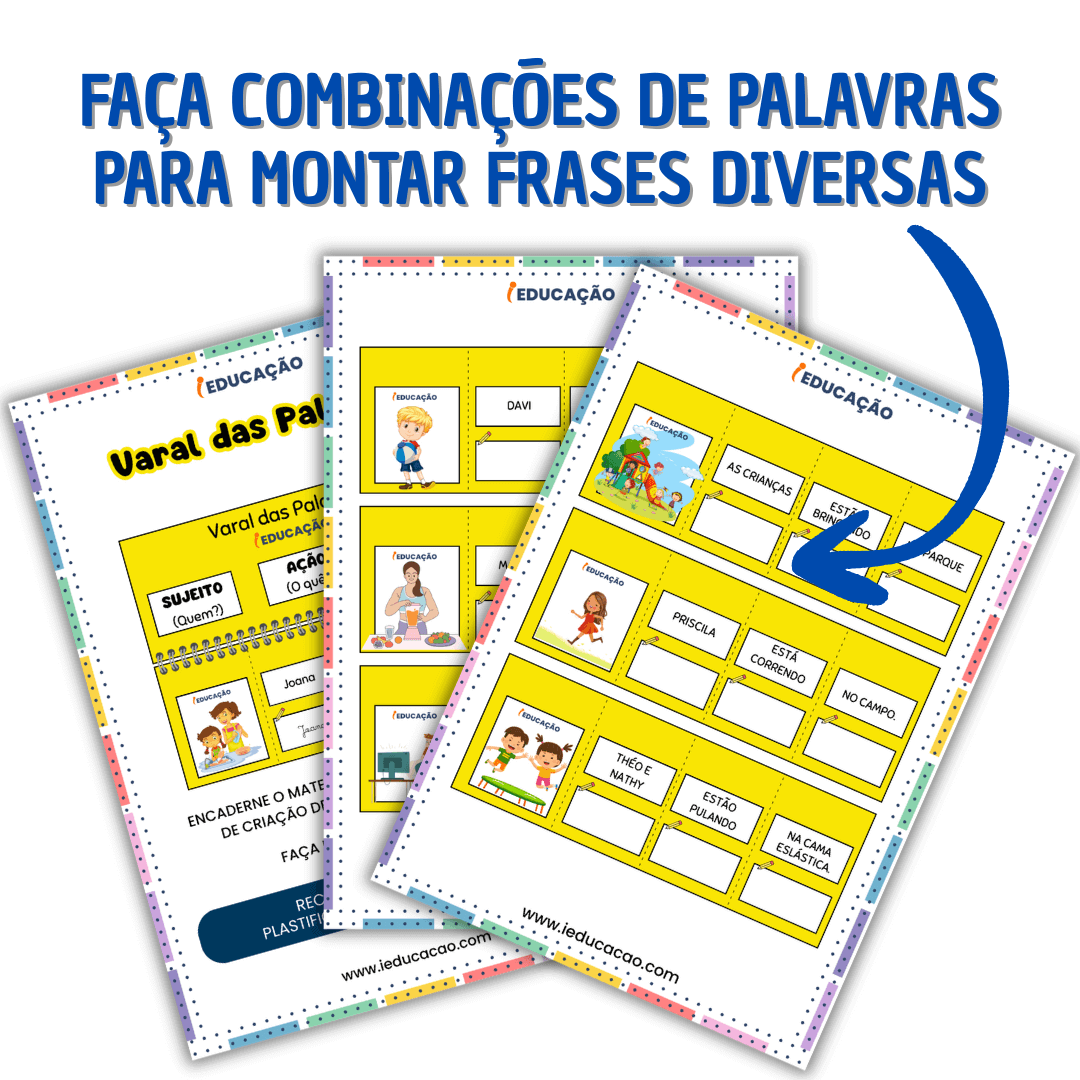
Atividade Lúdica de Alfabetização com Jogo das Palavras para Criar Frases -

**♥***♥** Diário da Profa Glauce **♥***♥**: Atividade: Formar frases ... -

Atividade de formar frases – Artofit
