Como modelar dados pra valer, não só seguir template de curso
Eu já vi gente criar schemas inteiros copiando figura do livro do Kimball e na hora da query o negócio travar. O problema não é saber o que é uma tabela fato ou uma dimensão. É entender quando usar cada uma e, principalmente, quando NÃO seguir o padrão cego. Vou explicar do jeito que eu aprendi depois de perder duas semanas refazendo um projeto.
Primeiro você precisa modelar a consulta, não o banco
O erro número um é começar criando tabelas. Comece listando o que você precisa responder. Se você quer saber "quanto vendeu por produto por região no mês X", aí você já tem o esboço da tabela fato e as dimensões que vão girar em torno dela. Eu sempre faço isso num papel ou num Google Docs antes de abrir o SQL.
Quando eu ia montar um esquema de vendas para uma operadora de telecom, eu fiz o que todo mundo faz: criei uma tabela fato com todas as colunas de medida que pareciam úteis. Vinte e sete campos. Duas semanas depois o pessoal de BI reclamou que as queries levavam minutos. Aí eu percebi o erro: eu tinha colocado coisas como tipo de chamador, operadora original, tipo de dispositivo, tudo na tabela fato. Na verdade, o analista só queria volume, receita e CHAMADAS, nada mais. Eu removi dezessete colunas, deixei só o necessário e as queries caíram para segundos. A lição foi clara: tabela fato deve ser estreita, não larga.
O que é tabela fato e tabela dimensão, de verdade
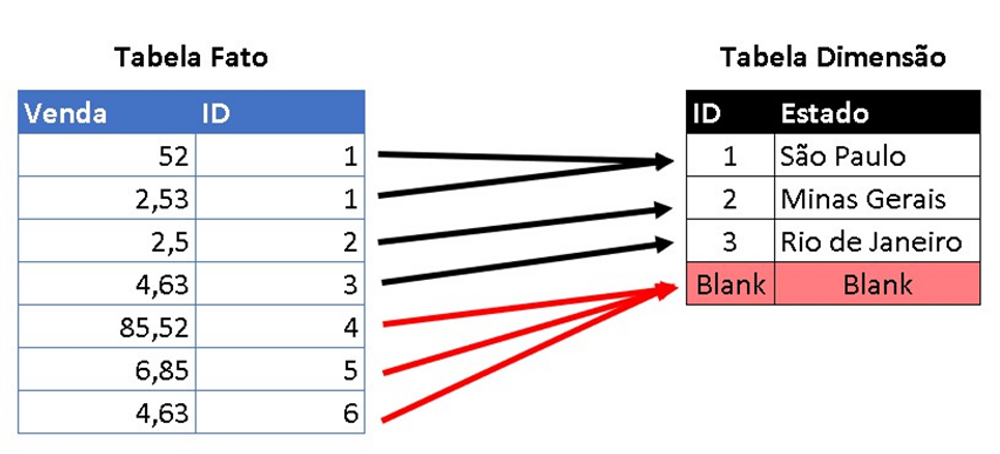
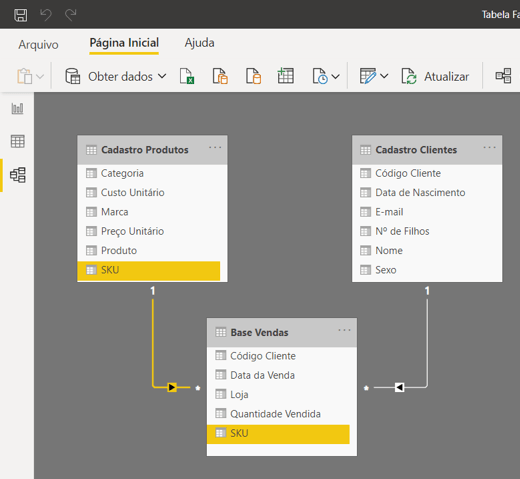
Uma tabela fato guarda eventos, transações, medições. Cada linha representa algo que aconteceu: uma venda, uma chamada, um login. Ela tem colunas numéricas e chaves estrangeiras que apontam para tabelas de atributos. Uma tabela dimensão guarda características descritivas: nome do produto, nome do cliente, data, categoria. Elas são acessadas pelas chaves na tabela fato.
O padrão que a galera ensina fala em "fatos atômicos", "grupos de fatos", "fatos relacionais". Isso existe, mas na prática eu raramente uso mais de um nível de granularidade por tabela. A maioria dos problemas que eu resolvi funcionou com uma tabela fato principal e quatro ou cinco dimensões. Quando o esquema fica complexo demais, você tá gastando mais tempo mantendo do que ganhando em agilidade.
A granularidade é o conceito mais importante. Se a sua tabela fato de vendas tem uma linha por pedido, outra por linha do pedido e outra por produto, você tem três níveis diferentes. Isso gera duplicação, confusão e erros de soma. Eu sempre defino a menor unidade possível (linha do pedido, por exemplo) e jogo tudo o que precisa ser agregado via GROUP BY na query.
Como eu estruturo na prática
Primeiro, escolho a granularidade. Segundo, monto a tabela fato com todas as chaves estrangeiras necessárias e só medidas puras. Terceiro, crio as dimensões correspondentes. Quarto, verifico se consigo responder às perguntas do usuário final com aquela estrutura. Se não der, ajusto a dimensão, não a tabela fato.
Um detalhe que pouca gente menciona: dimensões musicais versus dimensões escalares. Dimensão musical é quando você tem uma hierarquia bem definida, como data mês trimestre ano. Dimensão escalar é quando os atributos não têm ordem natural, como cor de produto ou status de chamado. Eu gosto de manter as musicais em tabelas separadas e as escalares inline na dimensão principal, porque isso simplifica as queries e evita joins desnecessários.
Aquilo que ninguém conta sobre manutenção
Tabela fato cresce. Sempre. O que parece inofensivo hoje vira um problema semana que vem. Eu tive um caso em que a tabela fato de logs de acesso chegou a 400 milhões de linhas em três meses. O schema estava correto, mas ninguém pensou em particionamento. As queries demoravam. A solução foi simples: particionar por data de forma que cada partição cobrisse um mês. O tempo caiu de quatro minutos para trinta segundos. Isso não tem a ver com modelagem conceitual, tem a ver com escolher o método de armazenamento certo desde o início.
Outra armadilha comum: scoping de medidas em grupos de fatos. Você pode ter uma tabela fato que agrega em nível de cliente e outra que agrega em nível de produto. Se você tentar juntar as duas numa única query sem cuidado, o resultado duplica linhas porque as granularidades são diferentes. Eu já vi relatórios errados serem aprovados assim. A solução é ou usar aggregations separadas ou aplicar técnicas de GROUPING SETS com critério claro de quais chaves compartilham qual medida.
Quando você deveria fugir do padrão
Se o seu volume é baixo — menos de cinquenta milhões de linhas por ano — a complexidade extra de esquema estrela talvez não valha a pena. Um banco transacional normal com índices adequados resolve rápido. Se o seu dado muda constantemente e não tem histórico claro, tabelas dimensionais de tipo 2 podem virar dor de cabeça sem necessidade. Eu desisti delas em projetos onde as mudanças de atributo eram raras e o custo de auditoria não compensava.
Às vezes, a melhor solução é uma tabela fato wide com dimensões achatadas. Funciona bem quando o negócio não exige profundidade analítica real e o tempo de entrega é curto. Não é elegant, é eficiente. Eu prefiro isso a passar três semanas implementando uma arquitetura perfeita que ninguém vai usar.
Downloads e exemplos práticos
Se você quer ver na prática, existe material aberto em repositórios públicos do GitHub. O BigQuery Samples tem exemplos de schemas de ecommerce, telecom e finanças com tabelas fato e dimensão bem documentados. Tem também o Sakila sample database, embora seja mais para prática SQL do que para estudo profundo de warehousing. Eu costumo recomendar também o conjunto de dados do TPCH, que é mais antigo mas ainda útil para treinar agregações em escala.
Para quem trabalha com ferramentas visuais, o dbt oferece exemplos prontos que você pode forkar e rodar localmente. Ele mostra como transformar tabelas brutas em modelos dimensionais usando SQL puro, sem depender de ferramenta proprietary. Eu uso isso para validar meu schema antes de subir para produção.
Eu costumo começar qualquer projeto respondendo estas perguntas: qual é a granularidade? Quantas linhas por mês? Quais medidas realmente importam? O que vai mudar com o tempo? A resposta determina se o esforço de modelagem vale a pena ou se você tá construindo casa de vidro pro vento.
Galeria
The Tabela Fato & Tabela Dimensão - Como diferenciar? | Moizés Júnior
📊 Tabela Fato e Tabela Dimensão — o que realmente muda na prática Uma ...
Tabela Fato e Tabela Dimensão no Power BI: Guia Prático
Você sabe a diferença entre uma tabela FATO e uma tabela DIMENSÃO ...
Qual a Diferença entre Tabela Fato e Tabela Dimensão no Power BI ...