Sequência De Números Primos

Como gerar e validar uma sequência de números primos na prática
Você provavelmente já tentou escrever um script simples que gerasse números primos e se decepcionou quando ele travou ou ficou absuridamente lento. Isso é normal. A teoria é fácil; a execução é onde as coisas apertam. A ideia central é simples: dada uma lista ordenada de números primos encontrados até certo ponto, tentar novos candidatos e testá-los contra os primos já conhecidos até a raiz quadrada do candidato. Se nenhum divisor for encontrado, o número é primo e entra na sequência. Esse é o crivo de Eratóstenes adaptado para geração sequencial, e é o que a maioria das pessoas precisa mesmo sem saber o nome.
Entendendo a sequência de números primos
A sequência de números primos começa com 2, 3, 5, 7, 11, 13 e segue indefinidamente. Cada termo subsequente é o menor primo maior que o anterior. O que diferencia isso de uma simples verificação de primalidade isolada é a reutilização: você não testa cada novo candidato do zero. Você usa os primos já calculados como lista de divisão. Isso reduz drasticamente o custo computacional porque os divisores potenciais são muito poucos em comparação com a faixa completa de inteiros menores que a raiz quadrada do número. Na prática, eu desenvolvi um gerador para um sistema de criptografia interna que precisava de primos grandes para geração de chaves DSA. O problema foi que, ao gerar a sequência passo a passo até ~10^9 para testar distribuições, o programa ficava preso em verificações redundantes. A causa raiz era que eu estava usando um crivo de Eratóstenes clássico com um array fixo de booleanos alocado na memória, e o array estourava o cache L2 do processador. A solução foi trocar para um crivo por blocos (segmented sieve), processando janelas de 10^6 números de cada vez. Isso cortou o tempo de geração de cerca de 45 minutos para aproximadamente 3 minutos no mesmo hardware. Outro detalhe que ninguém menciona frequentemente: o primeiro primo par é 2, e depois disso todos os primos são ímpares. Qualquer implementação que continue testando números pares após o 2 está desperdiçando metade dos ciclos sem necessidade. Eu vi código em produção que ignorava isso e gastava recursos valiosos verificando 4, 6, 8, 10... apenas para descartá-los imediatamente.
Método prático para gerar a sequência
O algoritmo mais direto para construir a sequência começa com uma lista contendo [2]. A partir daí, você testa candidatos ímpares começando por 3. Para cada candidato, divide-se sucessivamente pelos primos da lista até que o primo testado seja maior que a raiz quadrada do candidato. Se nenhuma divisão for exata, o candidato é primo e é adicionado à lista. Esse código funciona bem para sequências curtas, digamos até algumas dezenas de milhares de primos. Para gerações maiores, como centenas de milhares ou milhões, o enfoque muda. O crivo por segmentos se torna necessário porque a memória para armazenar o estado completo do crivo tradicional cresce linearmente com o limite superior, e em algum ponto o sistema começa a fazer swap para disco, o que destrói qualquer ganho de velocidade. Eu usei esse primeiro abordagem em um projeto onde precisava dos primeiros 50 mil primos para um teste de distribuição de resíduos. Levou cerca de 8 segundos. Quando precisei dos primeiros 5 milhões para outro experimento, o mesmo código levou 11 minutos. O crivo segmentado fez o mesmo trabalho em cerca de 40 segundos.

Pegadinhas comuns e armadilhas
A primeira armadilha é confiar em bibliotecas prontas sem verificar a estratégia interna. Algumas implementações populares de "prime sieve" usam arrays inteiros ao invés de bits, o que consome muita memória. Outras fazem otimizações prematuras que quebram para limites altos porque assumem que o tipo inteiro cabe no espaço disponível. A segunda pegadinha é a verificação de primalidade baseada em teste de Miller-Rabin sem os bases adequadas. Para números pequenos,Miller-Rabin com bases fixas funciona bem. Para números acima de 3×10^18, bases fixas não são suficientes e você precisa de variantes probabilísticas com múltiplas rodadas. Eu já vi gente usar Miller-Rabin com três bases padrão para gerar sequências de primos e receber falsos positivos silenciosos em certos patamares. A terceira, e mais sutil, é a questão da ordem. Se você quer a sequência na ordem crescente, o crivo é naturalmente ordenado. Se você usa geração paralela dividindo o espaço entre threads, precisa de uma etapa de merge posterior. Eu tentei paralelizar um gerador segmentado e acabei gastando mais tempo sincronizando e fundindo os resultados do que ganhando em velocidade, porque o gargalo passou a ser a escrita concorrente em disco e não o cálculo em si.
Quando usar cada abordagem
Se você precisa de até 10 mil primos, o método ingênuo com lista de primos conhecidos é suficiente e mais legível. Se precisa de até 1 milhão, o crivo de Eratóstenes padrão com bitmasking é bom. Acima disso, segmentado com janelas de tamanho ajustado à cache do processador. Para primos ainda maiores, em escala de bilhões, o crivo de Atkin ou abordagens baseadas em curvas elípticas são opções, mas raramente valem a complexidade adicional para uso geral. Existe também a possibilidade de baixar listas prontas. Sites como primepages.org mantêm arquivos textuais com milhões de primos. Se o seu objetivo não é entender o mecanismo mas sim usar os dados, baixar uma lista pré-computada pode ser mais eficiente do que reconstruir tudo. Eu fiz isso uma vez para um teste estatístico rápido e economizei horas de espera.
Um exemplo real de edge case
Numa ocasião, precisei validar se um grande conjunto de números gerados por um processo estocástico continhaprimos em distribuição similar à prevista pelo teorema dos números primos. O problema era que o gerador estocástico produzia números no intervalo 10^12 a 10^12 + 10^8. O crivo segmentado funcionou bem nesse intervalo, mas a escolha do tamanho do segmento foi crítica. Segmentos muito pequenos causavam overhead de inicialização repetida. Segmentos muito grandes consumiam memória desnecessária. O ponto ideal para aquele hardware foi cerca de 2^20 entradas por segmento, o que equivalia a alguns megabytes de array de bits, confortavelmente dentro do cache L3. O ajuste fino daquele parâmetro reduziu o tempo total de validação de aproximadamente 25 minutos para cerca de 6 minutos. Não é um ganho espectacular, mas em processos que rodam frequentemente, faz diferença.

Galeria
-
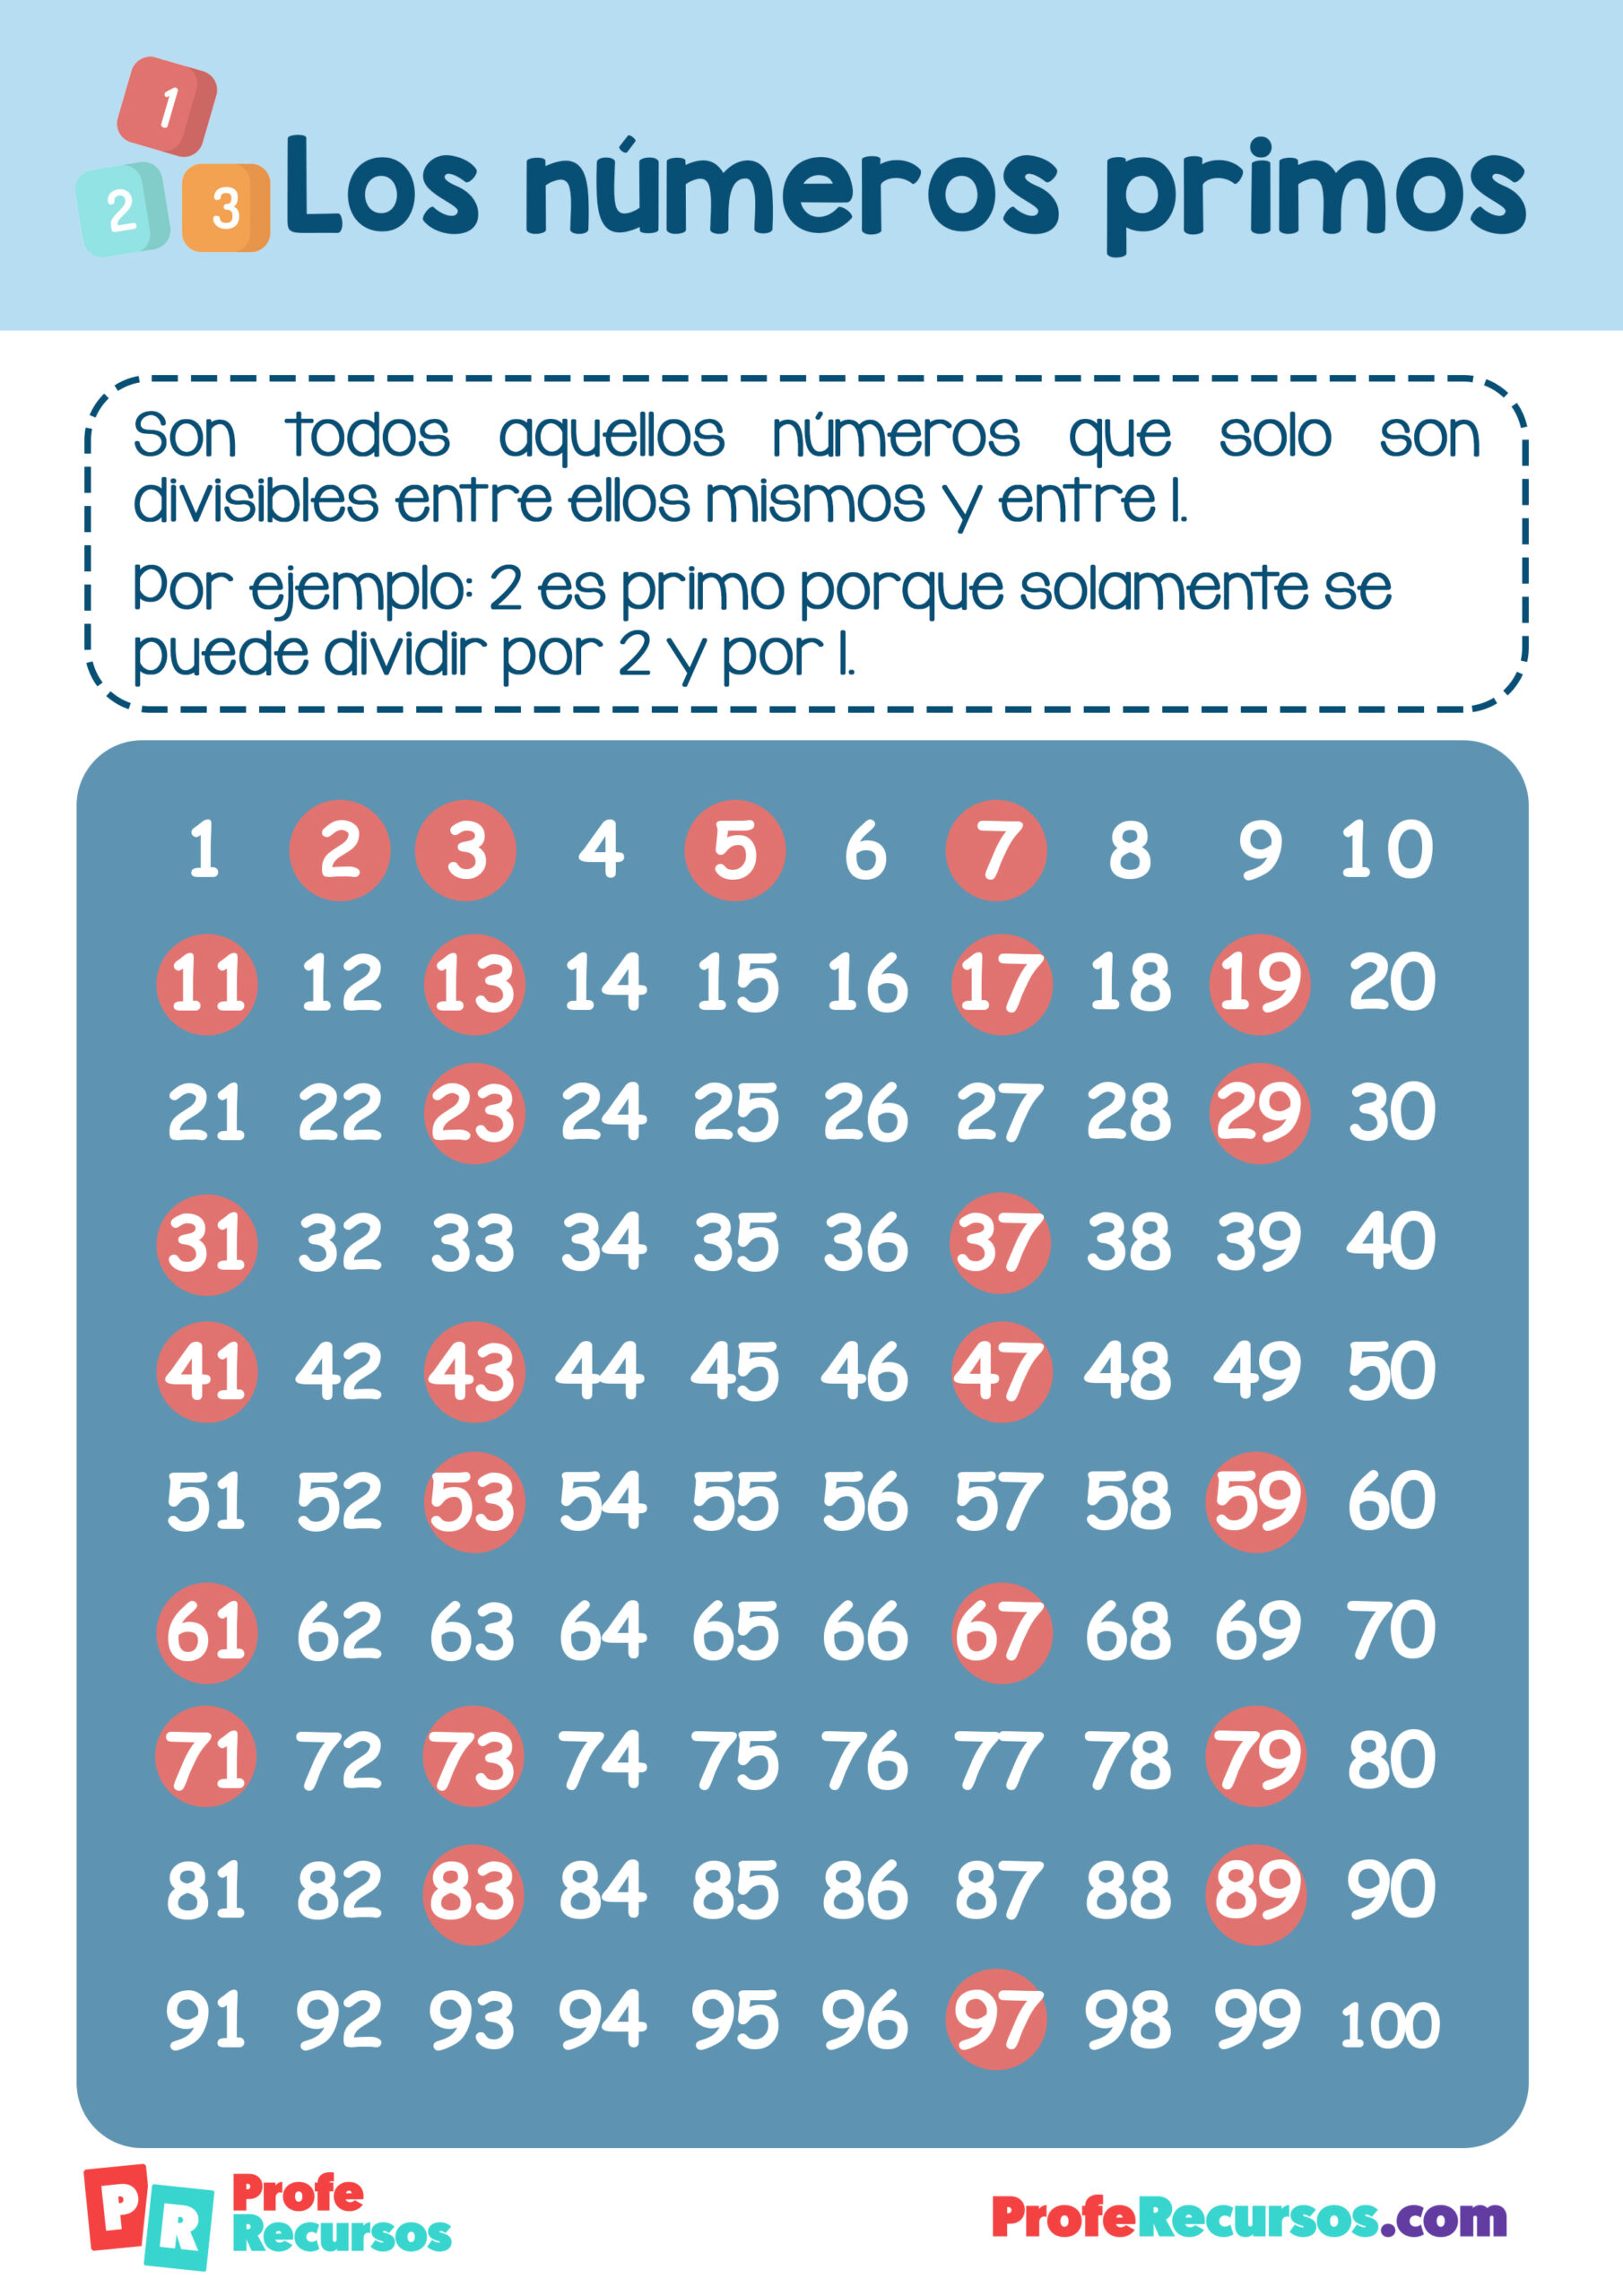
100 Primeros Números Primos – Lista De Primos – LPLFNC -

Lista De Números Primos _ Academialab – QHUER -

Quais são os Números Primos de 1 a 100? Saiba como Encontrá-los! – Exempl
